汇编基础语法
汇编基础语法
x86-64汇编核心语法包括:寄存器、寻址方式、指令系统、伪指令
寄存器(CPU数据容器)
x86-64有16个通用寄存器(64位):rax, rbx, rcx, rdx, rsi, rdi, rbp, rsp, r8, r9, r10, r11, r12, r13, r14, r15
rsi(源变址)、rdi(目的变址)是 pwn 里很重要的两个——负责传函数的第 1、2 个参数
r8–r15 是 x86-64 新增的,没有 16 位/8 位别名,只有r8d/r8w/r8b 这种小写后缀。
按功能可分为通用、段、指令指针寄存器,核心常用寄存器如下:
| 64位寄存器 | 32位别名 | 16位别名 | 8位别名(高/低) | 核心用途 |
|---|---|---|---|---|
| rax | eax | ax | ah/al | 累加器,存储运算结果、系统调用号 |
| rbx | ebx | bx | bh/bl | 基址寄存器,存储内存地址 |
| rcx | ecx | cx | ch/cl | 计数器,循环、函数参数 |
| rdx | edx | dx | dh/dl | 数据寄存器,扩展累加器、函数参数 |
| rsp | esp | sp | spl | 栈指针,指向当前栈帧的低地址段,(动态变化的“当前栈顶”) |
| rbp | ebp | bp | bpl | 基址指针,指向当前栈帧的高地址端,也就是这个函数栈帧的“基部/起点” |
| 指令 | 执行后 rax 的值 | 发生了什么 |
|---|---|---|
mov rax, 0x123456789ABCDEF0 |
0x123456789ABCDEF0 |
64 位全写,正常 |
mov eax, 0x12345678 |
0x0000000012345678 |
高 32 位被自动清零 —— 不是”只改低 32 位” |
mov al, 0x0F |
0x123456789ABCDE0F |
只改最低 8 位,其余 56 位保持不动 |
关键差异:写 32 位别名会清零高 32 位,写 8 位/16 位别名不会。这是 x86-64 的规则(32 位运算自动零扩展)。
寄存器别名:x86-64 最反直觉的设计
rax \ eax \ ax \ al 不是四个寄存器,他们是同一个寄存器的四个不同宽度的“取景器”。rax是64位的本体,eax / ax / al是从它的最低位(右侧)开始截取的不同长度
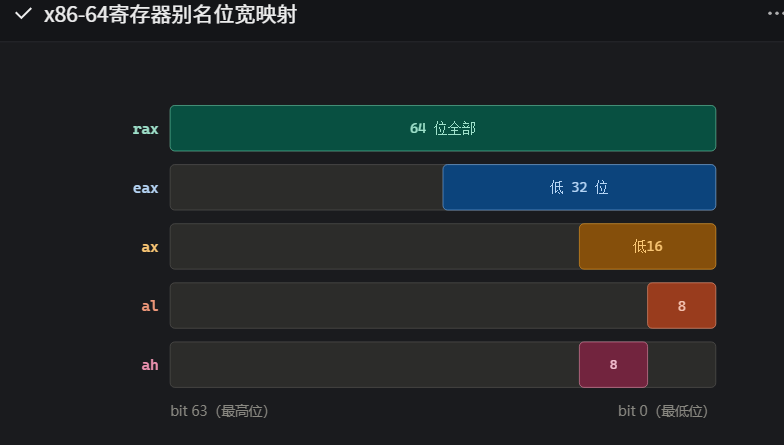
看图也知道一个常被误解的点:ah不是 rax 的高8位,而是 ax (低16位)里较高的那 8 位,也就是bit 8-15
寻址方式(访问数据的方式)
寻址方式(CPU怎么找到它要操作的那个数据)
前置名词
| 名词 | 人话解释 |
|---|---|
| 操作数 | 一条指令里被操作的对象。mov rbx, rax 里,rbx 和 rax 都是操作数。 |
| 源操作数 / 目标操作数 | 数据的来源和去向。Intel 语法是「目标在前」,所以 mov rbx, rax 是”把 rax 的值放进 rbx”。 |
| 寻址方式 | 一条指令告诉你”数据在哪”,但”在哪”有很多种表达方式。这些表达方式的总称就是寻址方式。 |
| 标签(label) | var、arr 这种名字。汇编器在编译时把它替换成一个具体的内存地址,但它本身不是变量。 |
| 段(section) | 程序被分块存放。.data 段放有初值的全局数据,.text 段放机器指令。 |
| db | define byte,定义 1 字节数据。 |
| 小端序(little-endian) | 一个多字节的数在内存里低位字节放在低地址。x86 用的就是这个规则。这是理解后面错误的钥匙。 |
| NASM | 一种汇编器(把汇编文本翻译成机器码的程序)。你这段代码是 NASM 语法。 |
四种寻址方式
x86-64支持多种寻址方式,核心常用4种,决定了如何获取内存中的数据:
1 | |
方括号 = 去内存取
rdx 和 [rdx] 是两个完全不同的东西:
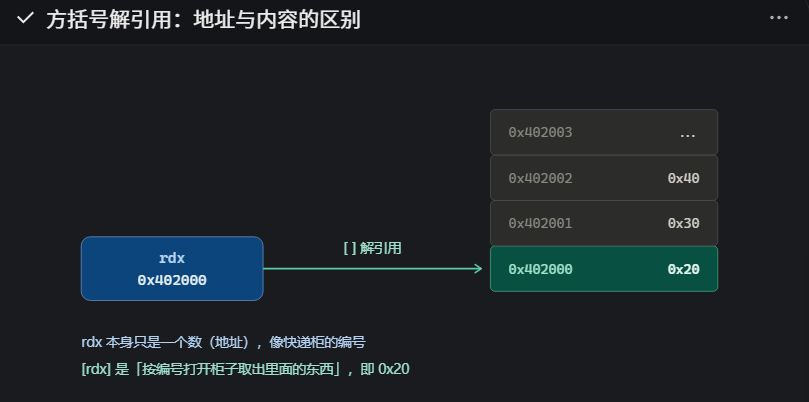
理解了这个区别,四种寻址方式就都通了。逐行过一遍:
| 行 | 寻址方式 | 讲解 |
|---|---|---|
mov rax, 0x50 |
立即数寻址 | 0x50 是写在指令里的常量,不来自寄存器也不来自内存。所以它只能当源操作数——mov 0x50, rax 是非法的,常量不能被赋值。 |
mov rbx, rax |
寄存器寻址 | 数据在 CPU 内部传,速度最快,不碰内存。 |
mov rcx, [var] |
直接寻址 | 地址写死在指令里。[var] = “去 var 这个地址取数”。 |
mov rdx, arr |
取地址 | 注意:这里没有方括号,所以是把 arr 的地址装进 rdx,不是取内容。这就是 C 语言里 char *p = arr; 的意思。 |
mov rsi, [rdx] |
寄存器间接寻址 | 地址不在指令里,而是存在 rdx 里。等价于 C 的 *p。 |
mov rdi, [rdx+1] |
间接 + 偏移 | 偏移 1 字节,等价于 C 的 *(p+1)。 |
这四种方式其实是一个公式的特例
x86-64的内存操作数有统一格式
[ base + index * sccle + disp ]
| 部分 | 含义 |
|---|---|
| base | 基址寄存器(任意通用寄存器) |
| index | 变址寄存器(不能是 rsp) |
| scale | 比例,只能是 1 / 2 / 4 / 8 |
| disp | 常数偏移 |
四种”寻址方式”就是这个公式删掉某些项的结果:
- 直接寻址
[var]→ base 和 index 都没有,只剩 disp - 寄存器间接
[rdx]→ 只有 base - 带偏移
[rdx+1]→ base + disp - 数组访问
[rbx+rcx*4]→ base + index × scale
scale 只能取 1/2/4/8,正是为了匹配 1/2/4/8 字节的数据宽度(char/short/int/long)。
核心指令系统(常用)
前置名词
| 名词 | 人话解释 | 简单易懂类比 |
|---|---|---|
| 指令 | CPU 能干的一个最小动作。mov、add、jmp 都是一条指令。 |
厨房菜谱上的一步:切、炒、盛。 |
| 操作数 | 一条指令涉及的数据。mov rax, 100 里,rax 和 100 都是操作数。 |
一步动作的原料和成品。 |
| 目的操作数 / 源操作数 | 数据要去哪 / 数据从哪来。Intel 语法里目的写在前。 | “把牛奶(源)倒进杯子(目的)”。 |
| 立即数 | 直接写在指令里的数字常量。100、0x0F 都是立即数。 |
菜谱上直接写的”两勺盐”。 |
| 寄存器 | CPU 内部极小的存储格子,速度最快,数量固定(几十个)。 | 厨师手边的调料碟,伸手就能拿到。 |
| 栈 | 内存里一块”后进先出”的区域,用来暂存数据。 | 一摞盘子,只能从顶上取放。 |
| 栈顶 | 栈里最后一个被放进去的位置。这台机器上栈是往下(低地址)长的。 | 那摞盘子的最上面那一个。 |
| rsp | 专门记录”栈顶在哪”的寄存器。 | 你手边的一个书签,标着盘子摞到第几层。 |
| 标志位(rflags) | 一个专门寄存器,不存数据,只存最近一次运算的”结论”(相等吗?负数吗?)。 | 裁判举的牌,记录上一回合谁赢。 |
| 按位运算 | 不是把两个数当整体算,而是把每个二进制位单独拿出来算。 | 两排开关,逐个对齐后分别决定开或关。 |
| 移位 | 把所有二进制位整体往左或往右挪几格,挪出去的位丢掉,空出来的位补 0。 | 一排人整体往左平移一格,最左边的人被挤出队伍。 |
| 有符号 / 无符号 | 同一串二进制,你可以把它当正数,也可以允许它是负数。两种视角下”谁大谁小”的结论可能相反。 | 温度计上的 -5℃ 和 5℃,跟里程表上的”跑了 5 公里”是两码事。 |
| 128 位 / rdx:rax | 两个 64 位寄存器拼起来当一个超大数用,专门伺候乘除法。 | 两个人的手接起来才够长,能抱住一个超大箱子。 |
| 汇编器(NASM) | 把汇编文本翻译成机器码的程序。 |
数据传送指令(最常用)
mov
——赋值,但不是“移动”
它的全称是move,但他的行为是复制,不是剪切;把源的值抄给目的,源本身不变
mov rax, 100-> rax被写成100mov rbx, rax-> 把rax的内容抄一份给 rbx。抄完之后 rax 还是100,不是被清空了
机器层发生了什么:CPU从源位置读出一个值,写进目的位置。mov不修改标志位(这点和add、cmp不同,逆向时很重要)
三个必知限制
不能内存直接传到内存。
mov [a], [b]是非法的,原因很朴素:CPU的连接线设计上只能“寄存器 <-> 内存”或“寄存器 <-> 寄存器”,没有“内存 <-> 内存”。想搬必须中转:mov rax, [b]然后mov [a], rax两端宽度必须一致。
mov rax, bl(64位 <- 8位)是非法的,得写成movzx rax, blmov的目标不能是立即数 或 rflags。不能给常量赋值
push
将数据压入栈(push操作数)
注意:它只有一个操作数,因为它操作的位置是固定的——永远是栈顶
只做两件事
rsp = rsp - 8(栈往下长,所以是减)- 把操作数的8字节写进新的
[rsp]
pop
将数据从栈弹出(pop操作数)
做两件事
- 把
[rsp]处的8字节读出来,放进操作数 rsp = rsp +8(缩回来)
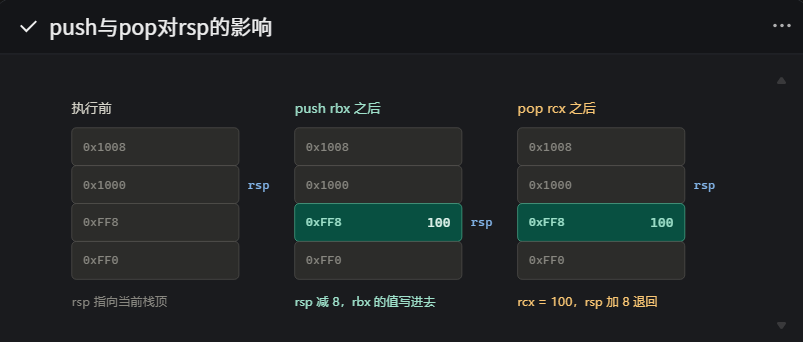
看上面的图,第三个状态里0xFF8位置上的100还在——pop只是把 rsp 移开了,并没有把数据擦掉。所以pop是“逻辑删除”,那块内存依然留着旧值。这个特性在pwn里非常关键:UAF(释放后利用)漏洞的本质,就是以程序以为内存“空了”,实际数据还在,而且被别人重新利用了。
顺序必须相反**:先push A 再 push B,取出来时必须先pop B(得到B)再pop A(得到A)。这就是”后进先出“
lea
只算地址,不开抽屉
全称Load Effective Address加载有效地址(lea寄存器)
它的写法长得像”访问内存“(有方括号),但执行时完全不碰内存:
| 指令 | 动作 |
|---|---|
mov rax, [rbx] |
打开 rbx 指的抽屉,把里面的东西拿出来给 rax |
lea rax, [rbx] |
不打开抽屉,只是把”rbx 这个编号”抄给 rax |
差别在 [rbx+8] 这种情况上最明显:lea rax, [rbx+8] 只是做了个加法(rbx 的值加 8),不会去读 rbx+8 处的内存
有两个实际用途:
- 算复杂地址。数组第 i 个元素的地址是
基址 + i × 元素大小,正好对应[base + index*scale]格式,一条lea就能算出来。 - 当加法器用。编译器非常爱用
lea rax, [rax+rax*2]来实现”乘 3”。原因是lea不修改标志位、不经过算术逻辑单元、而且机器码里不会出现 0x00 空字节(这点在 shellcode 里是硬需求)。
所以逆向时看到 lea 不要条件反射认为它在取地址——它经常只是在做加法。
示例
1 | |
补充:rdx 拿到的 200 这个结果,add rdx, rax 之类也能做到,但 lea 不会动标志位,也更容易被编码成不含空字节的机器码。
算法运算指令
add / sub ——加减法
1 | |
特点:结果直接写回目的操作数(原地修改),同时会设置标志位(ZF、SF、OF、CF)。这是它们和 mov 最大的区别。
示例
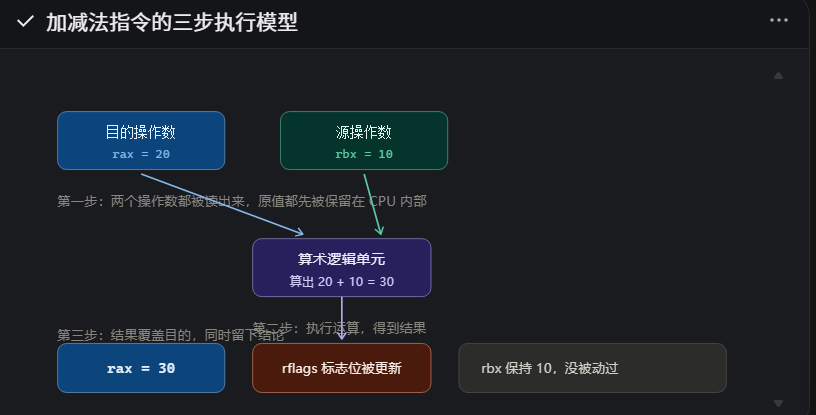
1 | |
mul / div
为什么乘除法要特殊对待
rax只有64位,能表示的最大值是 2^64 - 1。但两个64位数相乘,结果最大能到约 2^128,一个寄存器装不下。则除法反过来:被除数可能非常大,除法本身也需要”放不下的空间“来周转
而x86的解决方法很巧妙:把rdx和rax两个寄存器拼起来,当作一个 128 位的超大寄存器用,写作rdx:rax。其中 rdx负责高64位,rax负责低64位。
mul (无符号乘法)
1 | |
只有一个操作数。另一个乘数是隐含的rax,所以mul rcx的真正意思是rax * rcx。执行结果:
rdx = 乘积的高 64 位rax = 乘积的低 64 位
1 | |
mul用法
1 | |
在实际写代码时,如果确定结果不会超过64位,更推荐用有符号乘法的双操作数形式:
1 | |
imul这个名字是“有符号乘法”,但因为低64位的二进制乘法结果在有无符号两种视角下是完全相同的,所以它在只需要低64位时被广泛当成**“不会污染 rdx 的乘法”**来用,这是实际工程的一个使用技巧
检测乘法是否溢出,可以在乘法后立刻判断:
1 | |
不过要注意 mul 只保证正确设置 CF 和 OF 这两个标志位,其他标志位的状态是未定义的,所以不要依赖乘法后的 ZF 或 SF 做判断。
div
用法:
1 | |
也是单操作数,除数自己写,被除数隐含
含义是:被除数不是rax一个,而是rdx:rax这个128位的整体。执行结果分两处存放——商进rax,余数进rdx
原理:为什么被除数要这么设计?因为除法要能处理“被除数比一个寄存器能存的最大值还大”的情况。如果要除的数是200位宽,CPU没法处理,所以它规定被除数最多128位,用rdx:rax拼出来。这个设计有个副作用:rdx对除法来说不是“辅助寄存器”,而是被除数的高位部分——它参与了运算,不是可有可无的。
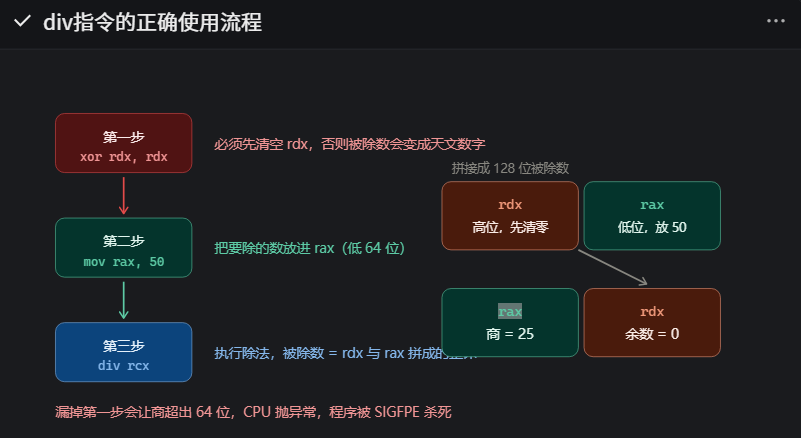
用法
第一步,动手之前必须先清空 rdx,写成 xor rdx, rdx。原因是 rdx 是 128 位被除数的高半部分,如果它里面残留着旧数据,那么被除数就变成了”旧数据 × 2 的 64 次方 + rax”,是个天文数字,除出来的商极可能超过 64 位,rax 装不下,CPU 就直接抛异常,Linux 下表现为程序被 SIGFPE(浮点异常信号)杀死,终端打印 Floating point exception。这个报错名字有点误导性,它跟浮点数没关系,是整数除法的异常。
第二步,把被除数放进 rax(低 64 位)。
第三步,写 div 除数,除数可以放 rcx 里,也可以直接是一个内存变量。
完整的写法是这样:
1 | |
还有一条红线:除数不能是 0。div 遇到除零会直接触发异常,程序崩溃。所以如果你写的除数来自用户输入,必须先检查它是不是 0,这正是很多真实漏洞的直接成因。
实用场景上,div 有一个特别常用的副产品——取余数。C 语言里的 a % b 就编译成一条 div,然后从 rdx 里读余数。所以要算”17 除以 5 的余数”:
1 | |
此外
有符号版本 idiv:如果被除数可能是负数,xor rdx, rdx 这一招就不好使了,因为负数的 128 位表示不是这样。比如 -50 的正确 128 位形式是高位全是 1、低位是 0xFFFFFFCE 这样的补码。这时候要用专门的指令 cqo(全称 convert quadword to octword,把 rax 的符号位复制着填满整个 rdx):
1 | |
同理,mul 的有符号版本是 imul。这组指令的存在意义就是:mul/div 把操作数永远当正数看,而 imul/idiv 会考虑符号位。
逻辑运算指令
前置知识
| 名词 | 人话解释 | 例子 / 类比 |
|---|---|---|
| 位(bit) | 最小的信息单位,只能取 0 或 1。8 位 = 1 字节,rax = 64 位。 |
一个开关,要么开要么关。 |
| 二进制 | 每位只能写 0 或 1 的计数方式,逢二进一。 | 十进制的 13 写作 1101。 |
| 权重 | 二进制每一位代表固定的数值大小,从右往左是 1、2、4、8、16…… | 1101 = 1×8 + 1×4 + 0×2 + 1×1 = 13。这是理解移位的钥匙。 |
| 十六进制 | 二进制的简写,一个十六进制位 = 四个二进制位。 | 0xF = 1111,0x0F = 0000 1111,0xA = 1010。 |
| 按位运算 | 不把两个数当整体算,而是拆开让每一位单独和对应位运算。 | 3 & 5 是 011 与 101 逐位比得 001(1);普通加法 3+5=8 是当作整体。 |
| 掩码(mask) | 专门用来筛选或控制某些位的数,本身往往没有数值含义。 | 一块打了孔的铁板:有孔的位留下,没孔的一律挡住。 |
| 补码 | 计算机表示负数的方式:正数按位取反再加一。 | 64 位下 -1 就是 64 个 1,即 0xFFFFFFFFFFFFFFFF。 |
| 标志位(rflags) | 一个专门寄存器,不存数据,只存最近一次运算的”结论”,每个结论占 1 位。 | 裁判手里的记分牌,后文的条件跳转全靠它下判断。 |
| ZF / SF / OF / CF | 分别为:结果为零、结果为负(最高位是 1)、有符号溢出、无符号进位或借位。 | 四张判罚牌。 |
| 逻辑运算对标志位的影响 | and、or、xor、shl、shr 会把 CF、OF 清零并更新 ZF、SF;not 谁都不碰。 |
所以 xor rax, rax 清零后能直接接 jz。 |
四种运算的逐位规则
| A | B | A and B | A or B | A xor B | not A |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 | 1 | 1 |
| 1 | 0 | 0 | 1 | 1 | 0 |
| 1 | 1 | 1 | 1 | 0 | 0 |
一句话抓住本质:
and是”两边1才得1”;or是”有1就是1”;xor是”不同才留 1”;not是”逐位反色”,且翻转的是全部 64 位,不是只翻低 8 位。
把规则落到实际寄存器上就是下面这张图,起点统一是 rax = 0000 1111:
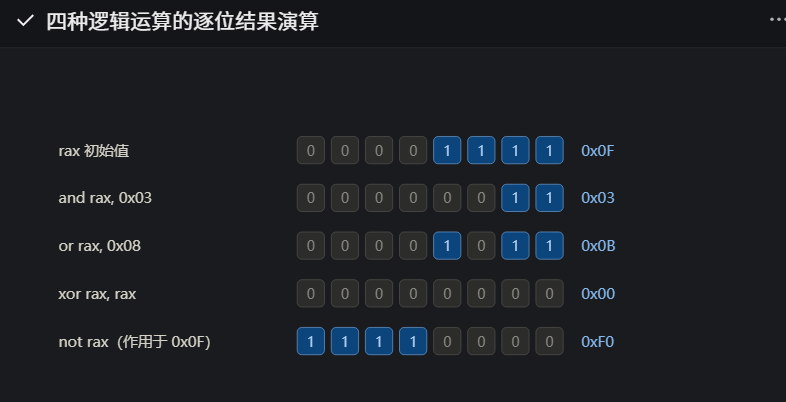
and(逐位与)
用法:and 目的, 源
含义:“两边都是1才得1”
**原理:**源操作数里为0的位会把目的的对应位无条件清零,为1的位则原样保留(因为 0 & x = 0,1 & x = x)。所以and的本质是“按掩码筛掉某些位”
| 实际场景 | 写法 | 说明 |
|---|---|---|
| 取低位(截断) | and rax, 0xFF |
只留最低 1 字节,高 56 位清零 |
| 对 2 的幂取余 | and rax, 0xF |
等价于 rax % 16,编译器常用这招替代除法 |
| 判断奇偶 | and rax, 1 后接 jz |
最低位为 1 即奇数(其他位的权重都是偶数) |
| 地址对齐 | and rsp, -16 |
低 4 位清零,对齐到 16 字节边界(系统调用常要求) |
| 检查某一位 | test rax, 0x4 |
检查要用 test,它同样只设标志位,但不破坏原值 |
or (逐位或)
用法:or 目的, 源
**含义:**只要有一个 1 就是 1
**原理:**与and镜像互补,源里为1的位把目的对应位强行置 1,为 0 的位原样保留(0 | x = x,1 | x = 1),所以它是强行点亮
| 实际场景 | 写法 | 说明 |
|---|---|---|
| 置位 | or rax, 0x08 |
bit3 无条件变 1,其他位不动 |
| 合并权限标志 | or rax, 0x2 |
叠加权限;用 or 不会误关掉已开启的位,add 会被进位搅乱 |
| 构造全 1 | or rax, -1 |
-1 的补码是 64 个 1,结果全 1 |
or 无法清位。要清掉 bit3 只能用 and rax, ~mask,~ 在汇编里对应的就是下文的 not。
xor(逐位异或)
用法:xor 目的, 源
**含义:**不同得 1
独有的性质是可逆:a xor b = c,则 c xor b = a。原因是异或记录的是”两个数在哪些位置不同”,再异或一次就把差异抹掉、还原原值。
| 实际场景 | 写法 | 说明 |
|---|---|---|
| 清零 | xor rax, rax |
3 字节(48 31 C0)且不含 0x00;mov rax, 0 是 7 字节且含多个空字节 |
| 加解密 | xor byte [p], 0x37 |
同一段代码跑两遍即还原,恶意样本常用它藏字符串 |
| 交换两寄存器 | 三步 xor 交叉 |
逆向题常出现;现代编译器少用(三步骤串行依赖,更慢) |
| 判断相等 | xor rax, rbx 后接 jz |
结果为 0 当且仅当两数每一位都相同,即完全相等 |
not (逐位取反)
用法:not 目的,单操作数,因为它不需要第二个数参照
**含义:**每一位 0 变 1、1 变 0,翻转全部64位()不是只翻低 8 位,not rax对0x0F得到0xFFFFFFFFFFFFFFF0
| 实际场景 | 写法 | 说明 |
|---|---|---|
| 生成清位掩码 | not rax 再 and |
清位的标准流程:先用 not 造掩码,再用 and 应用 |
| 求相反数 | not rax + inc rax |
等价于 neg rax(补码 = 取反加一),编译器有时这么生成 |
| 注意事项 | — | not 不修改任何标志位(与 neg 不同),后面接 jz 会读到更早那条指令的旧结论 |
shl / shr (移位)
用法:shl 目的, 位数,位数可以是立即数,也可以放在cl里(cl是 x86 历史上唯一允许指定移位次数得寄存器)。
**含义:**整体平移,移出去得位进 CF,空出去得位补0.
**原理:**每位权重都是2的幂,所以左移 n 位等于 2ⁿ,右移 n 位等于除以 2ⁿ 向下取整。
| 指令 | 空位补什么 | 用于 | 效果 |
|---|---|---|---|
shl |
低位补 0 | 有符号、无符号都可以 | shl rax, 3 = ×8 |
shr |
高位补 0 | 仅无符号 | 对负数会把符号毁掉:1111 0100(-12)右移成 0111 1010(+122) |
sar |
高位补原符号位 | 有符号 | 同一个 -12 右移得 1111 1010(-6),符合数学预期 |
| 实际场景 | 写法 | 说明 |
|---|---|---|
| 快速乘除 | shl rax, 3 |
移位比乘法指令快,编译器普遍这么做 |
| 提取高位 | shr rax, 32 |
取原高 32 位(原低位被挤出丢弃) |
| 拼接大常量 | mov + shl + or |
绕过 mov 立即数只能用 32 位的限制 |
| 捕获被移出的位 | shl rax, 1 后接 jc |
判断原最高位是否为 1(溢出检测常用) |
两条限制要记牢:移位次数按 64 取模,shl rax, 64 实际是”移 0 位”,什么都不做,shl rax, 65 等价于移 1 位;负数右移必须用 sar,用 shr 会把负数变成大正数。
控制转移指令(实现分支/循环)
前置知识
| 名词 | 人话解释 | 在这里的作用 |
|---|---|---|
| rip(指令指针) | 一个寄存器,存着”下一条要执行的指令在哪”。程序每执行一条指令,rip 就自动走到下一条。谁能改 rip,谁就控制了程序往哪跑。 | 所有跳转指令的本质都是”往 rip 里写一个新地址”。 |
| 标志位(rflags) | 一个专门寄存器,不存数据,只存最近一次运算留下的几个”结论”,每个结论只占 1 个二进制位。 | 它是 cmp 和条件跳转之间的传话筒:cmp 负责写,跳转负责读。 |
| ZF(零标志) | 结果为 0 时置 1。两数相减得 0 就意味着两数相等。 | je/jz、jne/jnz 读的就是它。 |
| SF(符号标志) | 结果的最高位是 1 时置 1。在有符号视角下表示”结果是负数”。 | jg/jl 判断有符号大小时要用它。 |
| OF(溢出标志) | 有符号运算结果越界(正+正=负之类)时置 1。 | 同样是 jg/jl 的判据之一。 |
| CF(进位标志) | 无符号运算产生进位或借位时置 1。 | ja/jb 这套无符号跳转读它。 |
| 标签(label) | 代码里的一个名字,汇编器在编译时把它替换成一个具体地址。它本身不是变量,只是一个”地名”。 | jmp label1 里的 label1 就是跳转目的地。 |
| cmp | 一条”只比较、不留结果”的指令,内部做一次减法,算完把结果扔掉,只保留标志位。 | 它是条件跳转的前置动作,几乎总成对出现。 |
| 顺流而下(fall through) | 如果没有任何指令改变 rip,CPU 就一条接一条往下执行。 | 这是汇编里最容易出逻辑错误的地方:忘写跳转,就会莫名其妙地执行到下一个标签的代码。 |
| 有符号 / 无符号视角 | 同一串二进制,按有符号读可能是负数,按无符号读是个巨大的正数。0xFF...FF 按有符号是 -1,按无符号是 18446744073709551615。 |
决定你该用 jl 还是 jb——用错方向,判断结论完全相反。 |
cmp
使用:cmp 目的操作数,源操作数
做的事:内部计算——目的 - 源,然后把结果丢掉,只把这次减法的特征(ZF、SF、OF、CF)写进标志位
向拿天平称两个包裹,目的只是知道”哪边重”,并不关心具体差多少克。
cmp rax rbx算的是rax - rbx,所以后面接jl表达的是“rax小于rbx“,也就是第一个操作数小于第二个操作数。
jmp
——无条件跳转
使用:jmp 标签
含义:直接把 rip 改成标签所在的地址,无条件、无理由
原理:它是最纯粹的”改路线“,不像条件跳转要看标志位脸色,jmp不读任何标志位,也不修改任何标志位
用处
第一个是做无条件分支,上面的分支执行完,必须跳到出口,不能顺流掉下去:
1 | |
第二个是做循环(向后跳转回上面的标签)。这是 jmp 配合条件跳转的经典组合:
1 | |
注意这里的分工:jmp 管”跳得动”,条件跳转管”什么时候停”。向后跳转(目标在当前指令之前)通常就是循环,向前跳转(目标在后面)通常就是分支——这是逆向时快速判断代码结构的经验。
第三个是间接跳转,也就是跳转目标不是写死的标签,而是从寄存器或内存里读出来的:
1 | |
这一点在 pwn 里至关重要:jmp rax 意味着”跳到哪”由数据决定。如果攻击者能控制那个寄存器或那块内存,就能让程序跳到自己想要的地方——C++ 的虚函数调用、函数指针数组、GOT 表跳转,都是这个机制,也都是漏洞利用的常见落脚点。
条件跳转家族
条件跳转的写法是 j条件 标签,含义是”读指定的标志位,满足就跳,不满足就往下走“。
同一行里的两条指令机器码完全相同,只是取了不同的说法:
| 指令 | 判据 | 含义 | 别名 |
|---|---|---|---|
je |
ZF = 1 | 相等就跳 | jz(零标志为 1) |
jne |
ZF = 0 | 不相等就跳 | jnz |
jg |
ZF=0 且 SF=OF | 有符号大于 | jnle |
jge |
SF = OF | 有符号大于等于 | jnl |
jl |
SF ≠ OF | 有符号小于 | jnge |
jle |
ZF=1 或 SF≠OF | 有符号小于等于 | jng |
ja |
CF=0 且 ZF=0 | 无符号大于 | jnbe |
jae |
CF = 0 | 无符号大于等于 | jnb、jnc |
jb |
CF = 1 | 无符号小于 | jnae、jc |
jbe |
CF=1 或 ZF=1 | 无符号小于等于 | jna |
js / jns |
SF = 1 / SF = 0 | 结果为负 / 非负 | — |
jo / jno |
OF = 1 / OF = 0 | 有溢出 / 无溢出 | — |
别名为什么这么起?规则是”加 n 表示取反“。jl 的反面是”大于等于”,所以 jl 也叫 jnge(not greater or equal)。认名字的规律比死记整张表轻松。
必须记住的坑:jl 和 jb 判断的是完全不同的东西。
拿 rax = 0xFFFFFFFFFFFFFFFF 举例,按有符号它是 -1,按无符号它是 18446744073709551615。执行 cmp rax, 1 之后:
jl会跳转,因为按有符号 -1 < 1;jb不会跳转,因为按无符号这个数远大于 1。
同一个数、同一条 cmp,两条指令给出相反结论。编译器生成的代码里这两套会混着出现(取决于源码里变量声明成 int 还是 unsigned int),逆向时判断错符号类型,就会得出完全错误的逻辑。
另一个重要性质:跳转指令自己不修改标志位。 jmp、je、jl 这些只管读和跳,不会碰 rflags。所以你可以一条 cmp 之后连续接好几个不同的条件跳转,它们看到的是同一份比较结果——这也是编译器愿意用 cmp + 多次跳转来组织代码的原因。
顺带一个工程细节:条件跳转有距离限制,跳得很近时汇编器用 1 字节的短跳转(机器码 2 字节),跳得远就用 4 字节的近跳转(机器码 6 字节)。写代码时不用管,但看机器码长度能判断跳转距离。
伪指令
简要
前面学的(mov、jmp 、syscall等等)是给CPU看的,伪指令是写给汇编器看的
| 名词 | 人话解释 | 例子 / 说明 |
|---|---|---|
| 机器指令 | CPU 能直接执行的动作,最终会变成二进制机器码,装进可执行文件。 | mov rax, 60、syscall 都是。 |
| 伪指令(汇编器指令) | CPU 根本不认识它,它只是给汇编器的一条”排版说明”或”登记信息”。汇编完成后它自己就消失了,不留任何机器码。 | section .text、global _start、len equ 10。 |
| 汇编器(NASM) | 把汇编文本翻译成机器码的程序。它负责处理伪指令、把标签换成地址、把数据排进内存。 | 类比:翻译官。伪指令就是你对翻译官说的”这页用大标题、这页加脚注”,成品里不会留下这些嘱咐。 |
| 链接器(ld) | 把汇编器产出的目标文件(.o)加工成可执行文件的程序,负责拼接各段、解析符号、确定入口地址。 |
nasm 出一个 .o,ld 把它变成可执行文件。 |
| 目标文件 / 可执行文件 | 前者是半成品(.o),后者是可以直接被系统加载运行的成品。 |
伪指令里的段信息先写进 .o,由链接器汇总成最终布局。 |
| 段(section) | 程序被分块存放,每块承担不同职责,且加载到内存后拥有不同的访问权限。 | 代码段只读可执行,数据段可读可写。这是伪指令存在的最主要理由。 |
| 符号(symbol) | 一个名字,代表一个地址或一个常量。链接器靠符号来把不同文件、不同位置连起来。 | _start、msg、len 都是符号。 |
| 小端序(little-endian) | 多字节的数在内存里低位字节放在低地址。x86 用的就是它。 | dq 0x123456789ABCDEF0 在内存里从低到高是 F0 DE BC 9A 78 56 34 12。 |
| 对齐(alignment) | 数据摆放位置要满足某种倍数要求,不满足时汇编器/编译器会插入空白字节(填充)。 | 为了让 CPU 一次就读到,多字节数据通常对齐到自己的宽度。 |
机器指令决定程序”做什么”,伪指令决定程序”长什么样”
section 段定义伪指令
使用:section 名字
作用是:告诉汇编器”接下来这段内容属于哪个段“。它本身不产生任何机器码,只是切换当前的工作台
原理上为什么非要分段?因为加载到内存后,每个段会被映射成有不同权限的内存区域。代码只需要读和执行、绝不允许改写(否则程序能改自己,也就意味着攻击者能改它);常量只读;变量要读写。这种”权限分离”是操作系统层面的保护机制,而它的前提就是——链接时程序必须明确告诉系统”哪块是什么”。
| 段 | 存什么 | 初值 | 加载后的权限 |
|---|---|---|---|
.text |
机器指令(代码) | 有 | r-x(可读、可执行、不可写) |
.rodata |
只读常量(字符串字面量等) | 有 | r–(只能读) |
.data |
有初值的全局变量/常量 | 有 | rw-(可读写、不可执行) |
.bss |
无初值的变量,只声明大小 | 无 | rw- |
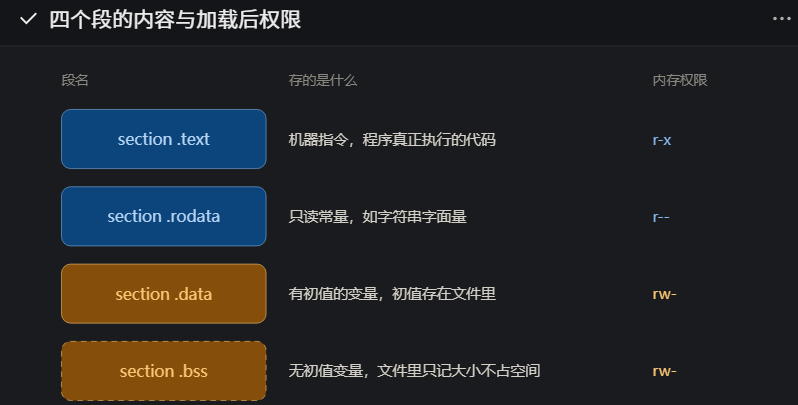
图里 .bss 用了虚线框,因为它在文件里不占空间——这是它和 .data 最本质的区别
具体怎么用:段声明是”分组开关”,写在哪一行,从这一行起的内容就归属那个段,直到遇到下一个 section。
1 | |
两个实践要点:
第一,.data 和 .bss 的区别在于有没有初值:db 0x10 有初值,初值必须真实写进可执行文件,所以放 .data;而 resb 64 只是”预留 64 字节,内容不重要”,如果也在文件里存 64 个 0,纯属浪费空间,所以放 .bss——加载器在程序启动时直接把这片区域清零,文件里只记录”要 64 字节”这一个数字。
第二,.bss 里只能用 resb/resw/resd/resq 这类”预留”伪指令,不能写 db 1 这种带初值的数据,否则汇编器会报错(逻辑上矛盾:既说不占空间,又要求存初值)。
变量定义伪指令:db / dw / dd / dq
这四个伪指令的作用是在数据段里开辟一块空间并填入初值,区别只在于每份数据占几个字节。
| 伪指令 | 全称 | 宽度 | 名字来源 |
|---|---|---|---|
db |
define byte | 1 字节 / 8 位 | byte |
dw |
define word | 2 字节 / 16 位 | word(x86 的”字”是 16 位) |
dd |
define doubleword | 4 字节 / 32 位 | double word |
dq |
define quadword | 8 字节 / 64 位 | quad word |
写法的固定结构是:标签 + 伪指令 + 初值。这里讲清一个容易搞混的点——标签(如 var1)代表的是”地址”,不是”值”。汇编器把 var1 登记为”这块数据的起始地址”,mov rax, var1 得到的是地址,mov rax, [var1] 才是去取内容。这和前面讲寻址方式时说的”有方括号才是访问内存”一致。
具体怎么用,五种常见形态:
1 | |
.bss 里则用”预留”版本,它们不带初值:
1 | |
关于 dq 0x123456789ABCDEF0 这一行,有个要掌握的:由于 x86 是小端序,这个数在内存里从低地址往高地址排是 F0 DE BC 9A 78 56 34 12——和我们书写时的顺序完全相反。这一点直接决定了两件事:
一. 是以后用 gdb 查看内存时会看到”颠倒”的字节序列,不要以为出错了。
二. 是写 payload 时,一个 8 字节地址必须按小端序排列才能正确覆盖返回地址。
还有一个延续:用多大的指针去读,决定了读到几个字节。var1 db 0x10 只定义了 1 字节,如果写 mov rax, [var1],汇编器会去读 8 个字节,把后面的 w1、d1 的头部字节一起卷进来。正确写法是 movzx rax, byte [var1]。
常量定义伪指令:equ
使用:名字 equ 值
**作用:**给一个值起个别名,这个别名在编译期就被替换掉
它和变量有本质区别:equ不占任何内存、没有地址、不是变量
更像是”文本替换“:汇编器看到len就替换成10,产出的机器码里只有10,没有len这个东西。
具体怎么用,三个典型场景:
1 | |
第三行那个 $ - msg 是很实用的技巧。$ 是 NASM 里的特殊符号,表示当前这一行的地址;msg 是字符串起始地址。两者相减就是字符串占用的字节数,而这个计算在编译期就完成了,运行时不做任何运算,也不占用额外指令。写 write 系统调用时,长度参数经常就用这招自动算出来,改字符串就不必手动改长度了。
两点补充。第一,equ 定义的值不能在后面修改,因为它压根不是存储单元,不存在”修改”这回事。第二,NASM 里还有两个相关写法:%define 是真正的宏(可以做参数替换,比 equ 更灵活),%assign 定义的是可以重新赋值的数字常量。日常写小型汇编,equ 已经够用。
入口声明:global_start
使用:global 符号位
**作用:**把符号导出成“全局可见”,让链接器在处理其他文件时能看到它
原理要结合链接过程理解:汇编器把每个 .asm 文件翻译成独立的 .o 文件,此时文件里的标签都是”本地符号”,外面看不见。global 相当于在符号表上盖一个”对外公开”的章。链接器在拼接所有 .o 文件时,只能看到被公开的符号——程序入口也必须是公开符号,否则链接器找不到入口在哪儿。
具体怎么用:
1 | |
extern 是 global 的反向操作,用于引用外部符号(比如调用 C 库函数)。
如果不写 global _start,链接时会报 undefined reference to '_start' 或 cannot find entry symbol _start——这两个报错你早期一定会遇到,根因就是”入口符号没公开”。
顺便说明一个容易被误解的点:_start 这个名字不是随意起的。链接器 ld 默认就把 _start 当作程序入口,这个约定和 ELF 文件头里那个”入口地址”字段对应。你写 C 程序时用的是 main,那是因为 C 运行时库会先执行一段准备代码,再由它去调用 main;而在纯汇编里没有这层包装,所以直接以 _start 作为起点。