ELF文件概述
前置
文件在磁盘上其实只有两种本质形态:文本文件和二进制文件。
- 文本文件:里面存的是人能直接读懂的字符,比如
.txt、.c源码、.md。拿记事本打开,看到的是一行行文字。 - 二进制文件:里面存的不是字符,而是机器直接能懂的 0 和 1(以及被组织成各种结构的原始数据)。拿记事本打开,看到的是一堆乱码
^@、�之类,因为那些字节根本不是给人看的。
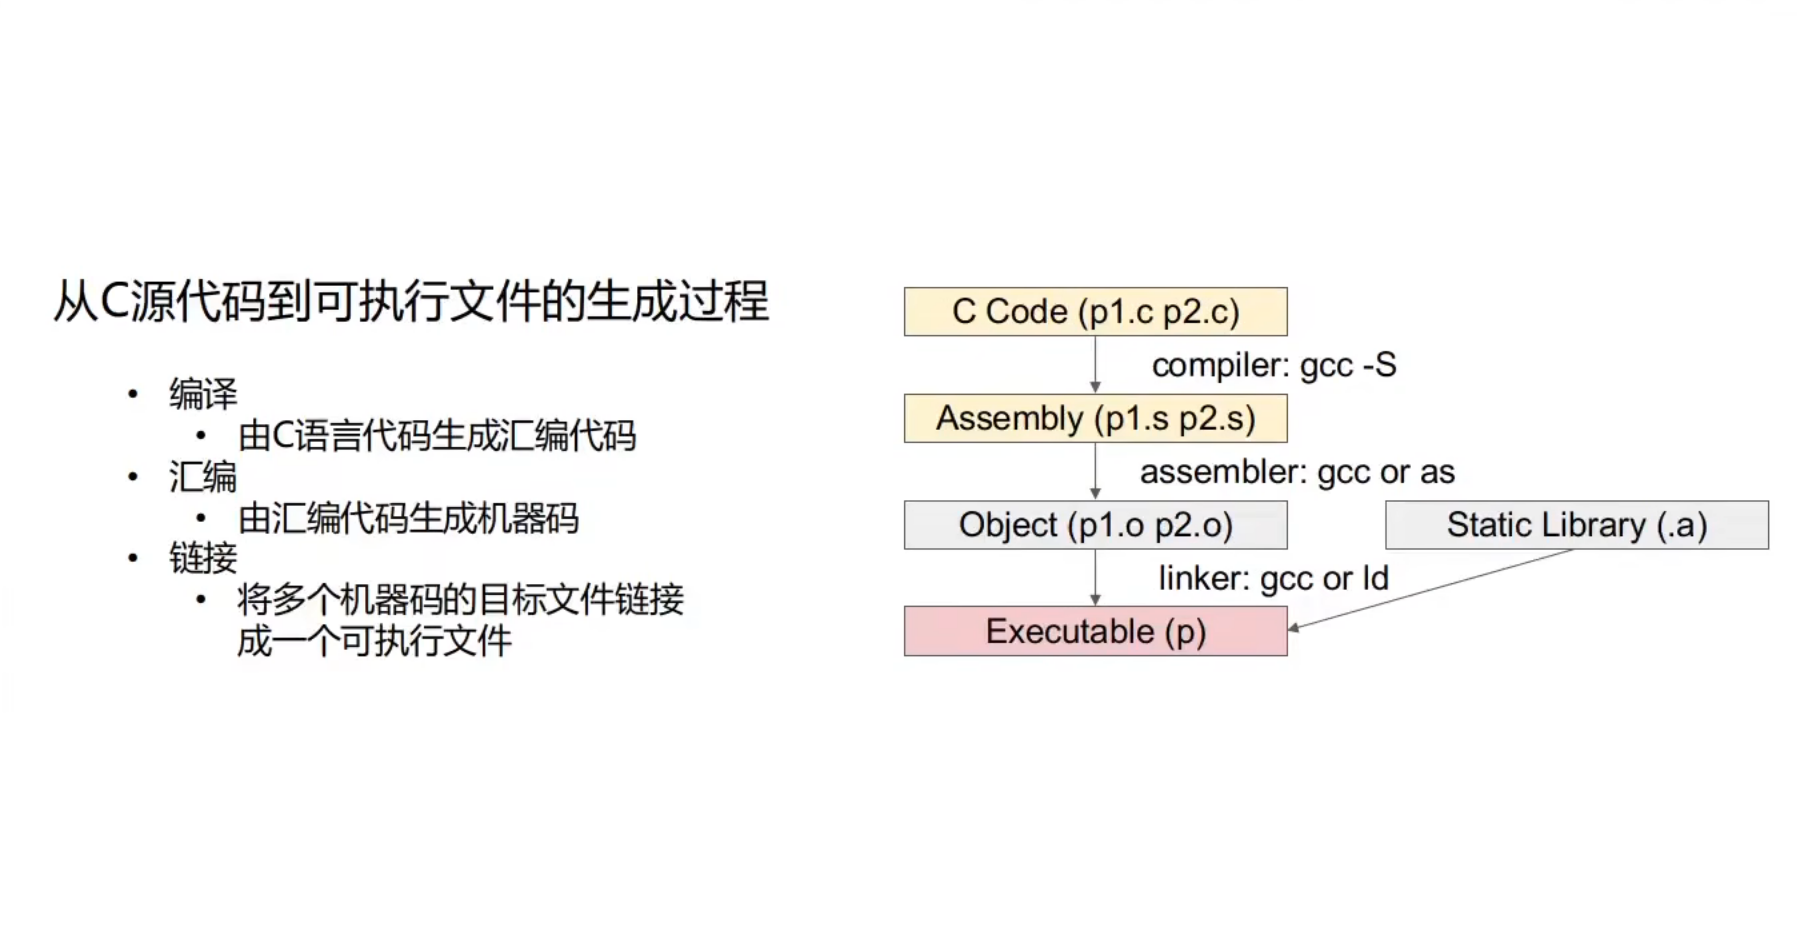
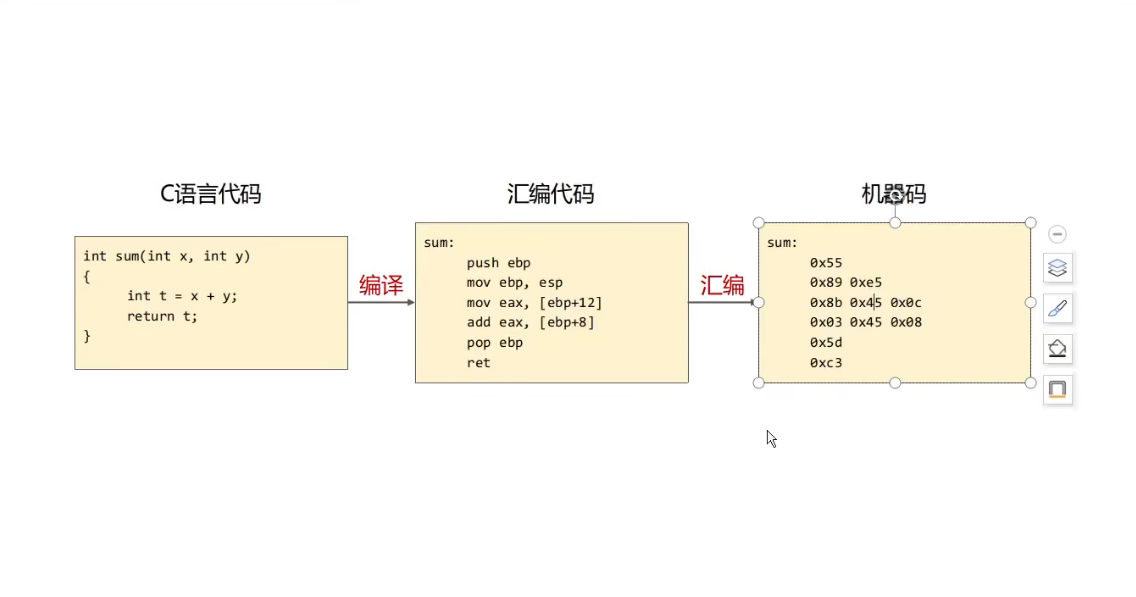
一个 C 程序从源码到能运行,要经历几个阶段:
- 编译:把写的
main.c这种文字源码,翻译成机器指令。这一步的产物是目标文件 .o(也叫 object file)。此时这个.o还不能直接运行,因为它里面可能还欠着账——比如调用了printf,但printf的实现不在文件里,机器不知道它到底在哪。 - 链接:把一堆
.o文件(以及库)拼到一起,把那些”欠账”(未解决的符号引用)一一对上号,最后得到一个可执行文件,才能真正跑起来。
编译 = 把每个工人各自的零件图纸加工成零件;链接 = 把所有零件组装成一台能转动的机器。ELF 的”可重定位文件”对应的就是”零件”(.o),”可执行文件”对应的就是”组装好的整机”。
共享库(shared library)
就是”一个程序副本、多个程序一起用”的库。好处是省内存、省磁盘,还能独立升级库而不必重新编译所有程序。Linux 下对应 .so 文件,Windows 下对应 .dll。
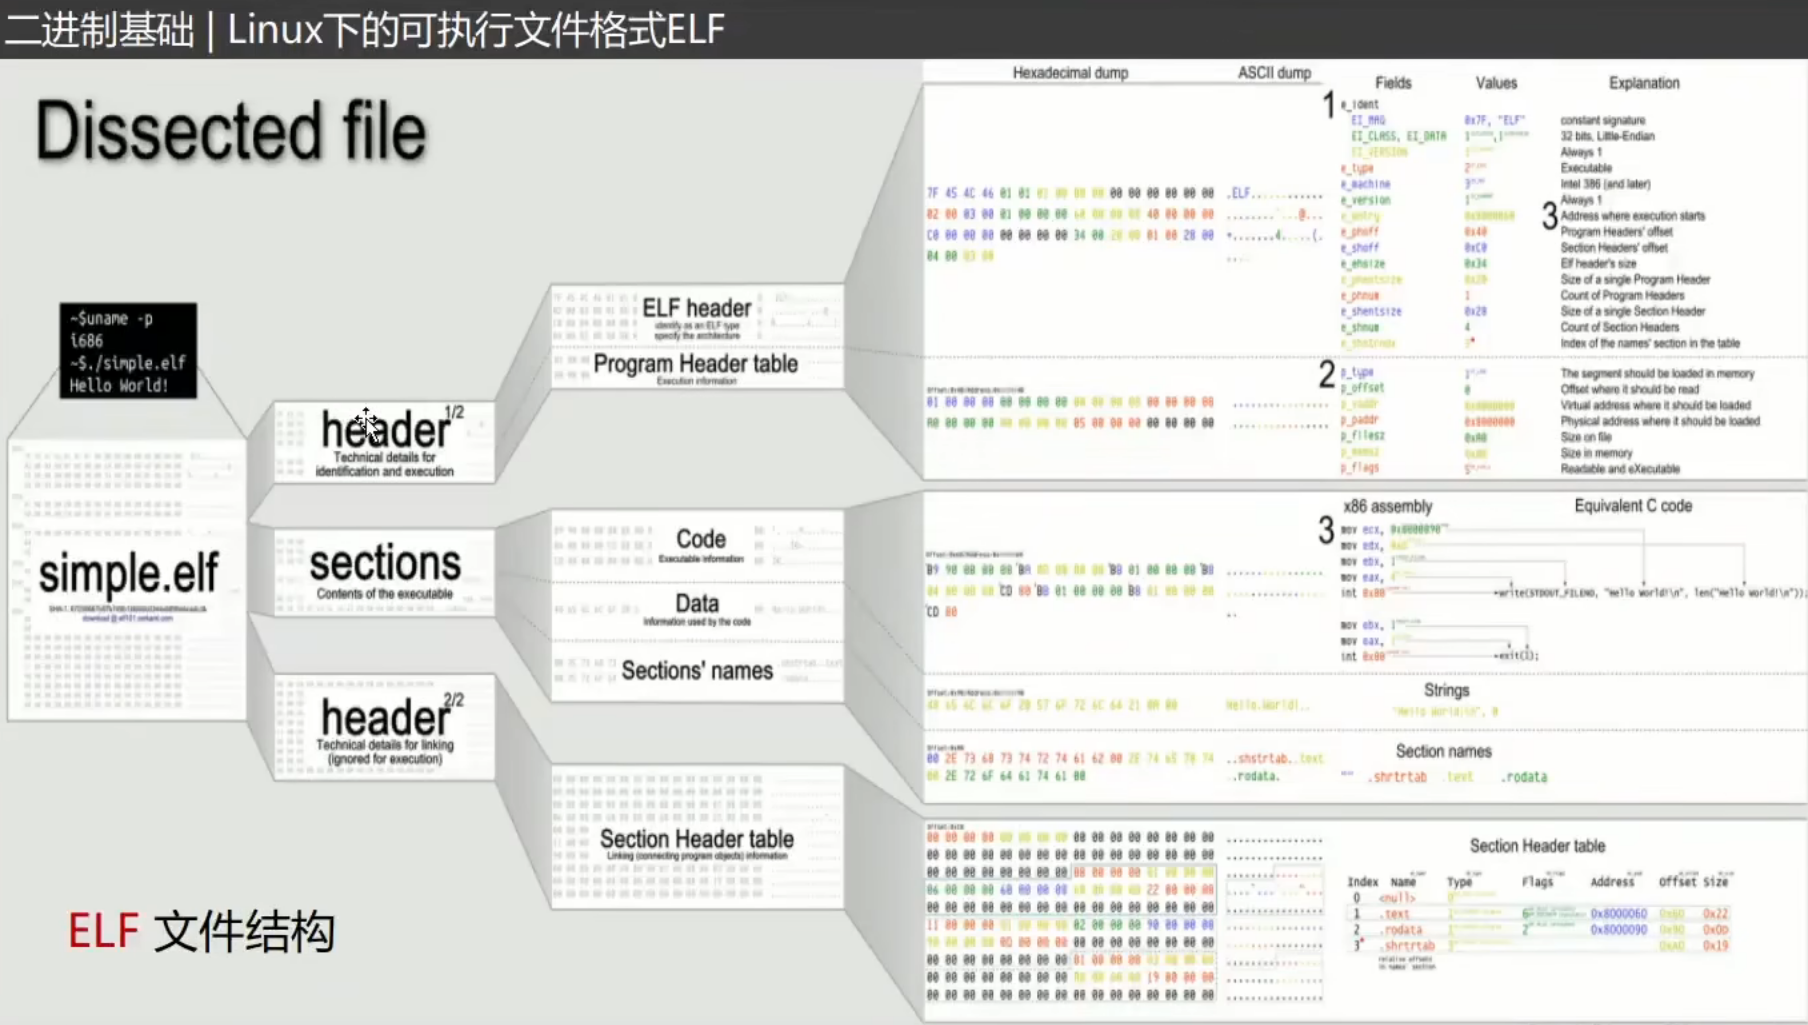
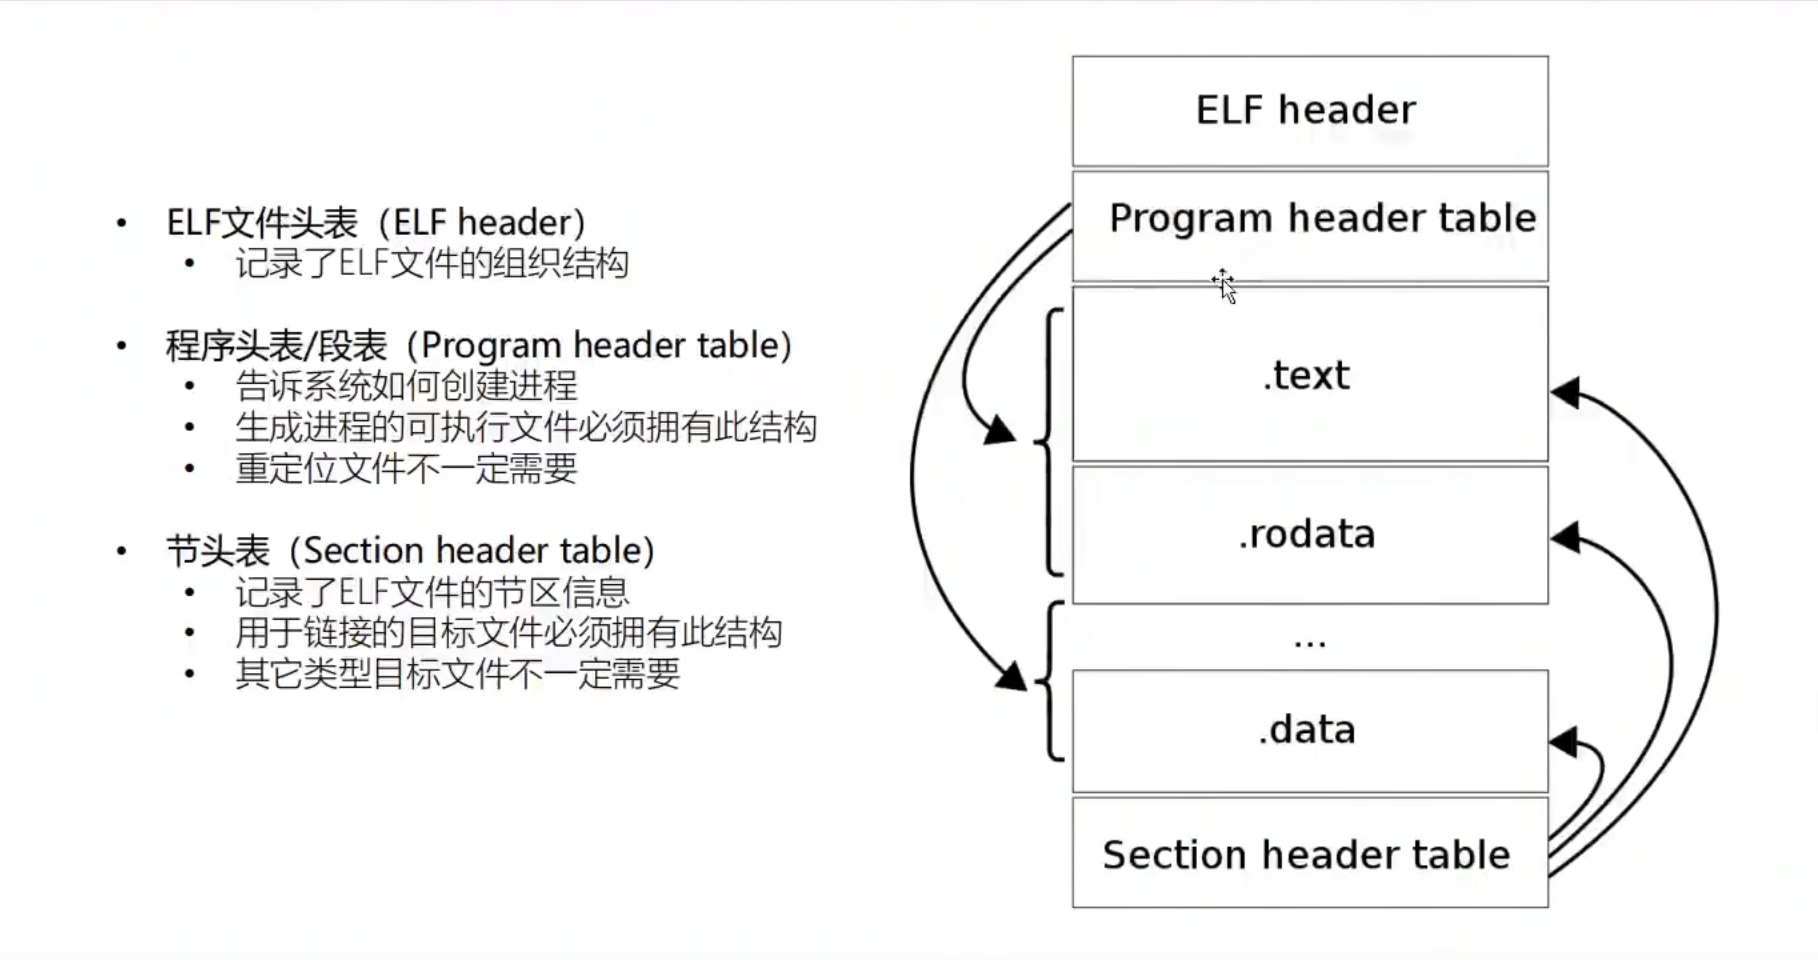
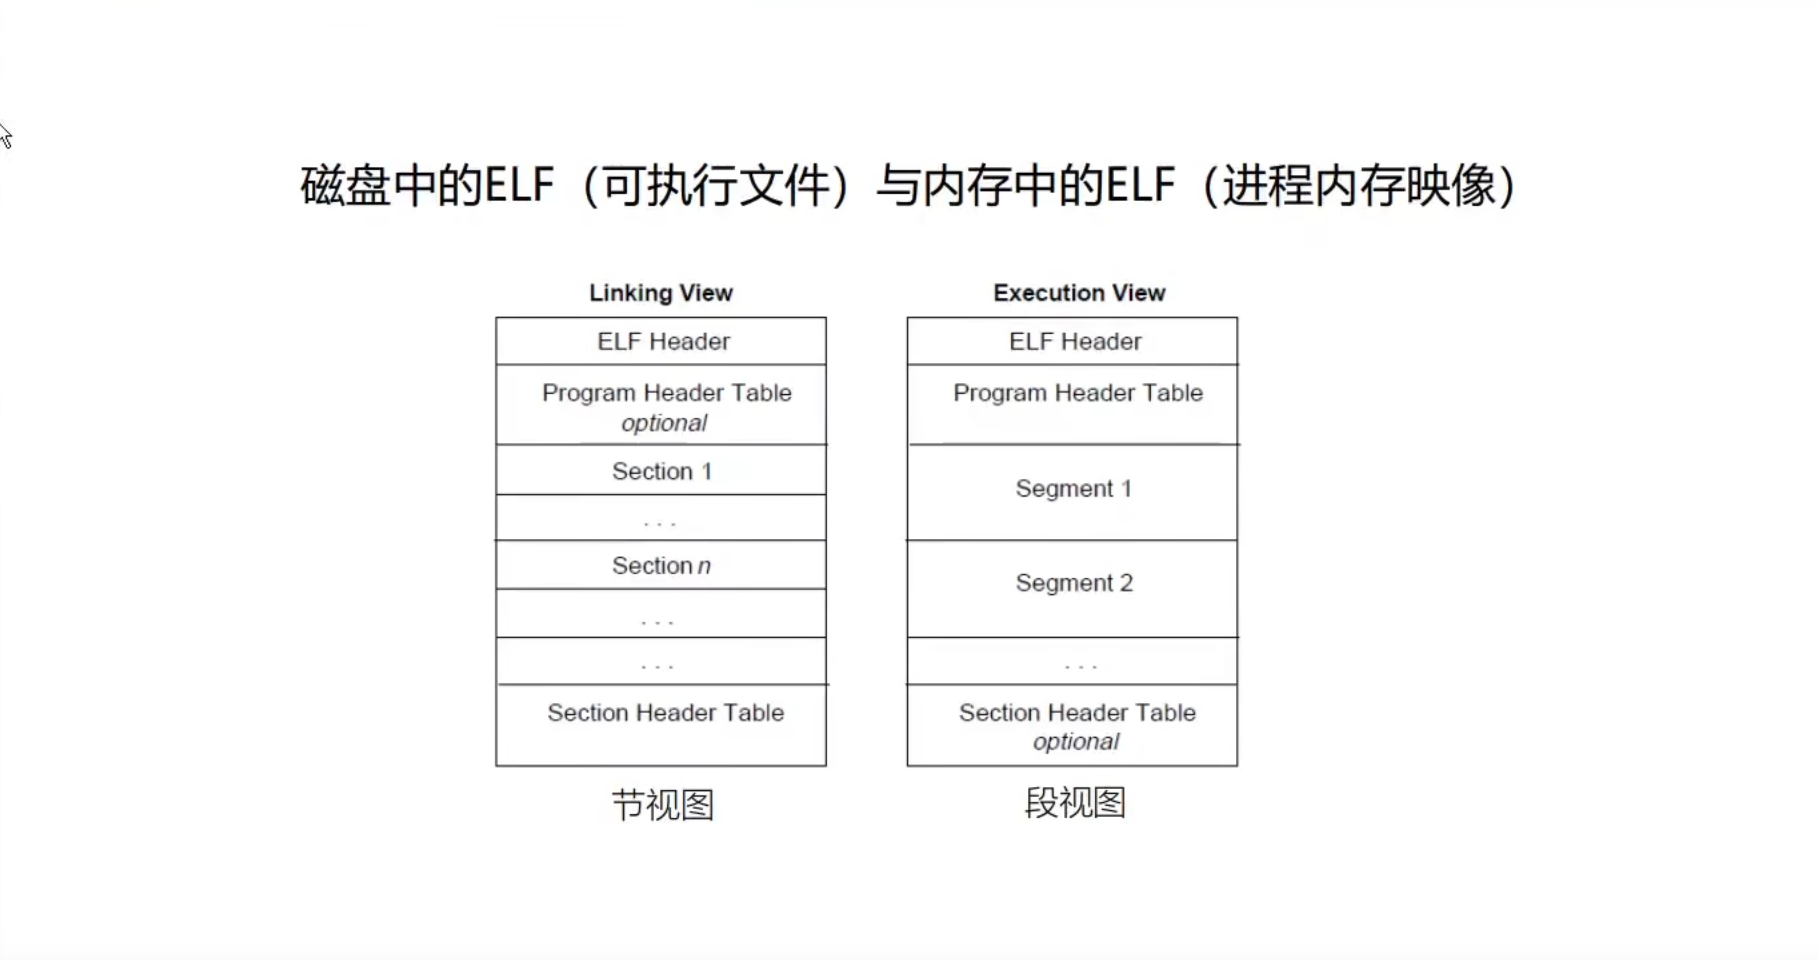
ELF文件是什么
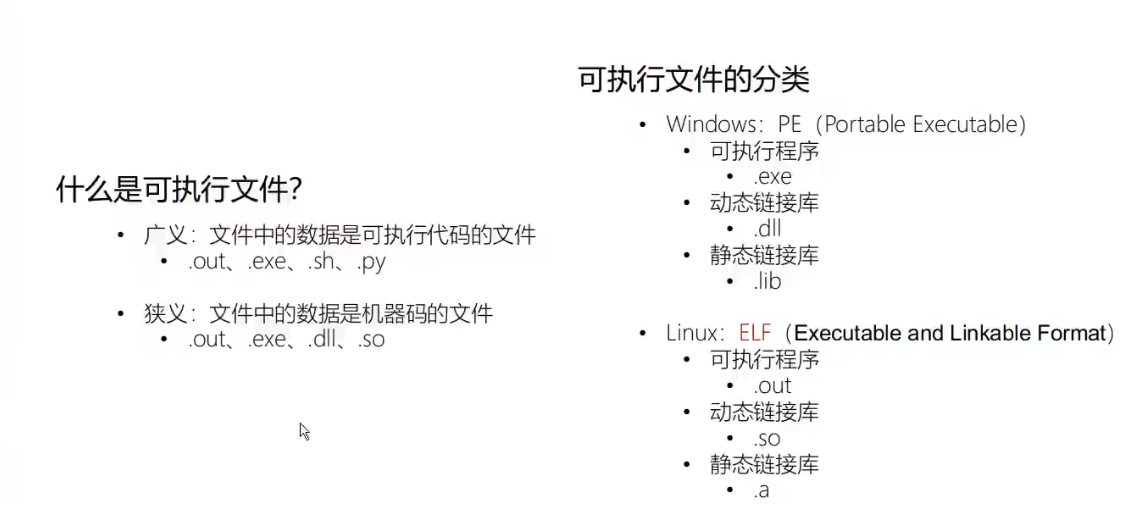
ELF的全称是Executable and Linkable Forma(可执行可链接格式), 是Linux 和 Unix-like 系统中最核心的二进制文件格式,用于可执行程序、目标文件、共享库和核心转储文件
ELF的文件格式主要有4种
可重定向文件(Relocatable File)
包含代码和数据,用来被链接成可执行文件或共享目标文件,里面的代码数据还没被安排到最终的、固定的内存地址上,所以可重定向。.o文件在还没链接之前,不知道自己最终会被拼到整机的哪个位置,所以它内部很多地址只能用“占位符”表示。
**用法:**假设有个foo.c,想把它编译成目标文件(不链接),命令是:
1 | |
-c表示“只编译,不链接”。得到的foo.o就是一个可重定向文件。可以用工具查看他确实是ELF格式:
1 | |
这个foo.o现在不能直接运行,如果想确认它的类型,用readelf:
1 | |
file、readelf 是查看文件格式的工具
可执行文件(Executable File)
可直接运行的程序,包含代码、数据、入口点地址等
这个最好理解,就是在终端里敲 ./a.out、ls、cat 能直接跑起来的东西
三个关键组成:
- 代码:翻译好的机器指令,CPU 直接执行。
- 数据:程序要用到的变量、常量(比如全局变量、字符串字面量)。
- 入口点地址:就是操作系统加载后 CPU 从哪开始执行。这是可执行文件和可重定位文件的一个关键区别——可执行文件必须有确定的入口点,而可重定位文件没有(因为它还没拼装完)。
用法:
1 | |
用工具查看类型
1 | |
或者看入口点地址:
1 | |
共享目标文件(Share Object File)
包含可链接的代码和数据,主要有两个作用:
1)与其他可重定向文件或共享目标文件链接生成可执行文件;
2)动态连接器在运行时加载动态库文件,如:动态链接库(.so)
**共享:**一份代码,多个程序同时用,而不是每个程序都自带一份拷贝——省磁盘、省内存、库可以独立升级
作用1:链接时用
生成可执行文件时,连接器可以把某个.so作为输入,和.o文件一起链接,产出可执行文件。这是“静态意义上的参与构建”
作用 2:运行时用(Executable)
这是 .so 更常见的用法。可执行文件里并没有把库代码拷进去,它只记录了一句”我运行时需要用到某个 .so“。等程序真正跑起来时,由**动态连接器(dynamic linker/loader,Linux 下叫 ld.so)**负责把这个 .so 从磁盘加载进内存,接到程序上。
用法:
查看一个可执行文件依赖哪些共享库:
1 | |
查看 .so 自身的类型:
1 | |
一个小细节:可执行文件和共享目标文件在 readelf 里看到的 Type 分别是 EXEC 和 DYN。现代 Linux 上很多可执行文件(PIE,位置无关可执行文件)也会显示成 DYN。
核心转储文件:
当程序意外崩溃时,用于调试分析的内存镜像,如:core-dump文件,程序崩溃瞬间的”内存快照”
“内存镜像” :就是程序崩溃那一刻,它占用的整块内存被原样保存下来,包括当时的代码、数据、调用栈(函数调用层级)、寄存器值等,供事后分析”当时到底发生了什么”
用法:
Linux 上 core dump 默认可能被关闭或限制,可以这样开启:
1 | |
然后让一个会崩溃的程序运行,崩溃后会生成一个叫 core(或 core.xxx)的文件。用 file 看它:
1 | |
调试时配合调试器 gdb:
1 | |
core dump 是信息泄露的常见来源之一。程序崩溃时,core 文件里可能残留敏感数据(密码、密钥、内存中的明文),如果 core 文件权限没设好,或者被攻击者拿到,就能从里面挖出秘密。所以生产环境通常关闭 core dump,或严格限制其权限。
四种类型的关系
这四种 ELF 文件不是孤立的,它们串起了程序”从源码到运行再到崩溃”的完整生命周期。用一张图收束:
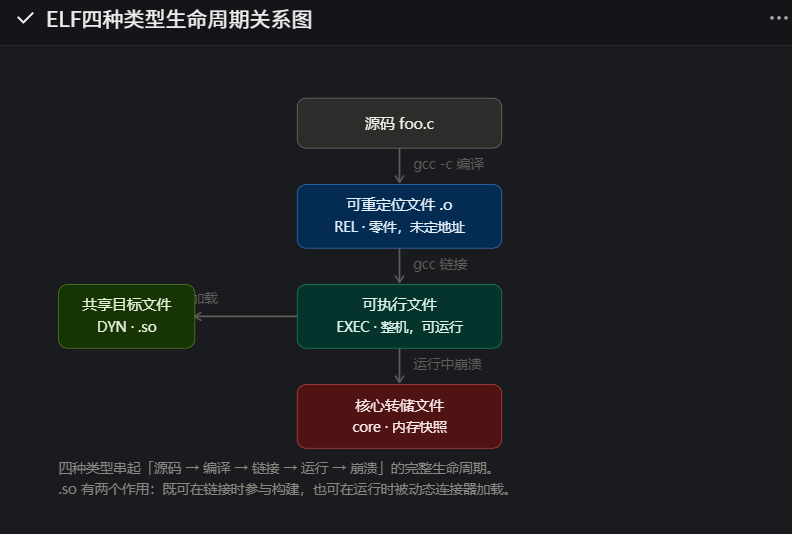
图中能看到一条主链条:源码 → 可重定位文件 → 可执行文件 → 核心转储文件,而共享目标文件从侧面接入可执行文件(既在链接时、也在运行时)。
| ELF 类型 | readelf 的 Type | 常见后缀 |
|---|---|---|
| 可重定位文件 | REL | .o、.a |
| 可执行文件 | EXEC | 无(如 a.out) |
| 共享目标文件 | DYN | .so |
| 核心转储文件 | CORE | core |
ELF文件里有什么
前置
节(Section)与段(Segment)
- 节:链接器视角的细粒度划分,把文件里同性质的内容(代码、已初始化数据、未初始化数据……)各归各的”房间”。
- 段:加载器视角的粗粒度划分,把若干节打包成”一整层楼”,按整块内存统一管理。
内存权限(R / W / X)
内存的一块区域可以有三种权限:R(可读 read)、W(可写 write)、X(可执行 execute)。这是 CPU 硬件层面强制的——代码写了也没用,访问违规内存会直接被系统杀死(以后常见的”段错误”就是这么来的)
C 语言里的四种变量——理解后面变量”住哪”的关键
- 全局变量:定义在函数外面,整个程序都能访问。编译时就分配好位置。
- 静态变量(static):加了
static的变量,”只在本文件(或本函数)内可见”,但存储方式和全局变量完全一样——都是编译时就定好的。static改变的是”谁能看见它”,不是”它住在哪”。 - 局部变量:函数内部定义,函数运行到那行才诞生,函数一返回就消失,住在一个叫栈(运行时自动分配的临时内存区)的地方。
- 初始化 vs 未初始化:定义时就给了值(
int a = 5;)叫初始化;没给值(int a;)叫未初始化。
四个最常见的节名
| 节名 | 装什么 | 权限 |
|---|---|---|
.text |
代码(机器指令) | 可读、可执行 |
.data |
已初始化的可写数据 | 可读、可写 |
.bss |
未初始化的可写数据 | 可读、可写 |
.rodata |
只读数据(字符串字面量等) | 只读 |
ELF根据文件格式的不同可分为两种视图
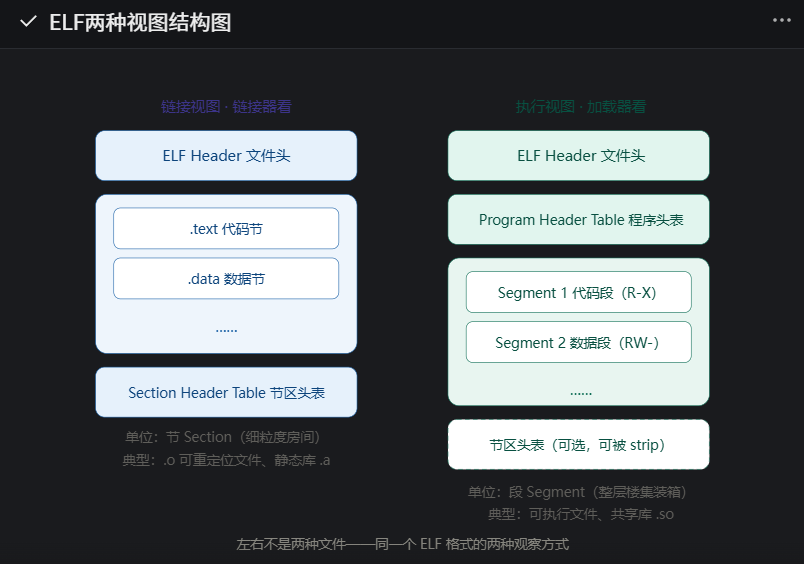
不是存在”两种 ELF 文件”,而是同一套 ELF 格式有两种视图,节和段不是两套内容,而是同一份内容的两种打包粒度。
链接视图
由 ELF 文件头、节、节区头表组成,以 Section 为单位,一般是可重定位的目标文件。
三个组成部分,从上到下:
- ELF 文件头:整个文件的“身份证 + 总目录”,永远在最开头。
- 节(Section):中间一大块,被切成一个个小房间——
.text代码一间、.data数据一间……各归各。 - 节区头表(Section Header Table):一份“房间清单”,每一项描述一个节:叫什么名、什么类型、在文件的第几个字节、多长、有什么属性。没有这张清单,链接器进楼就是两眼一抹黑。
为什么链接器要细粒度? 因为链接器的工作是“拼装 + 对账”:从几十个 .o 里挑出需要的节拼到一起、把符号引用一一对上。房间分得越细,拼装取舍越灵活。这正好呼应上次:可重定位文件(.o)和静态库(.a)就是这个视图的主角——它们是待拼装的“零件”。
执行视图
由 ELF 文件头、程序头表、段和节区头表(可通过 strip 等操作去除)组成,以 Segment 为单位,一般是执行文件或共享库。
- ELF 文件头:同样在最开头(两种视图共用同一个文件头)。
- 程序头表(Program Header Table):加载器专用的“装箱单”,每一项描述一个段:从文件哪里搬、搬到内存哪个地址、多大、什么权限(R/W/X)。
- 段(Segment):把若干权限相同的节打包成一大块。典型如“代码段”(把
.text等装一起,权限 R-X)和“数据段”(把.data、.bss等装一起,权限 RW-)。 - 节区头表(可选):这一项对运行不是必需的。
关于“可通过 strip 去除”这句,补充一个细节:传统上 strip 工具主要剪掉的是符号表和调试信息,节区头表还在;较新版本的 strip/objcopy 默认连节区头表也一并移除。无论哪种情况,程序照样能正常加载运行——因为加载器只认程序头表,根本不看节区头表。剪掉损失的是“给人看、给工具看”的信息。
怎么一会是节,一会是段
它们是同一份内容的两种组织粒度,服务两个不同的角色:
| 节 Section | 段 Segment | |
|---|---|---|
| 给谁看 | 链接器 | 加载器 |
| 粒度 | 细(每个房间) | 粗(整层整层) |
| 划分依据 | 内容性质(代码/数据/只读数据) | 内存权限(可读/可写/可执行) |
| 出现阶段 | 编译后就有 | 链接后才形成 |
两者的桥梁是程序头表:它把“哪些节装进哪个段”的映射关系记录下来。
机器层面,一个典型的段表项记录着:类型(LOAD = 需要装载)、在文件中的偏移、装到内存的虚拟地址、文件中占多大(p_filesz)、内存中占多大(p_memsz)、读写执行权限。
文件头里有什么?
文件头固定在文件最开头,主要内容包括:
- 魔数(magic):最开头 4 个字节,固定为
7F 45 4C 46(即0x7F+"ELF")。作用是“验明正身”——操作系统和工具一看这 4 个字节就知道“这是个 ELF”。 - 类别(class):32 位还是 64 位。
- 字节序(endianness):多字节数字在内存里“先放高位还是低位”。大端 = 像正常书写数字先写千位;小端 = 先写个位(x86 用小端)。
- 类型(Type):就是上次
readelf看到的REL / EXEC / DYN / CORE——上次那张四种类型的速查表,落点就在文件头这个字段里。 - 机器架构:x86-64、ARM 等。
- 入口点地址(Entry point):启动开关位置
- 两张表的位置和大小:程序头表在文件第几字节、有几项;节区头表在第几字节、有几项。所以文件头像“总目录页”,告诉你两份“分目录”各在书的第几页。
两个头表各有什么作用?
- 节区头表 = 链接器的“货架清单”:描述每个节的名称、类型、位置、大小、属性。链接器靠它找零件。
- 程序头表 = 加载器的“装箱单”:描述每个段从文件哪里来、到内存哪里去、什么权限。加载器靠它布置内存。
对应的完整加载流程一句话:加载器读程序头表 → 按表项把各段搬进内存 → 给内存贴上 R/W/X 权限标签 → 把 .bss 对应的内存清零 → 跳到入口点开始执行。
由此还能推出一个规律:.o 文件只有节区头表、没有程序头表(零件还没到“搬进内存”那一步,不需要装箱单);可执行文件和 .so 两张表都有;core dump 文件主要按段记录内存快照。
ELF文件头
前置
1. 数据结构(struct)
先补一个最底层、材料通篇都在用的概念。C 语言里的 struct(结构体)是“把一组相关数据打包成一个整体”的语法。比如把“姓名、年龄、电话”打包成一个“人”结构。ELF 的每个组成部分——文件头、节区头表项——都是用一个 struct 来定义的,struct 里一个个字段(成员)就是这一条条信息。
2. typedef
它是 C 语言里“给类型起别名”的关键字。比如 typedef uint32_t Elf32_Word; 的意思是:“从今以后,Elf32_Word 就是 uint32_t 的另一个名字”。为什么费这劲?为了跨平台可读——uint32_t 谁都知道是“32 位无符号整数”,但看不出它在这一行是用来干嘛的;叫 Elf64_Addr 一眼就知道“这是 64 位 ELF 的地址类型”。起别名是为了让代码“自解释”。
3. 无符号 / 有符号整数,以及固定宽度类型
- 有符号(signed):能表示负数,如
int32_t范围约 ±21 亿。 - 无符号(unsigned):只表示非负数,同样 4 字节但范围是 0 ~ 42 亿。
uint16_t / uint32_t / uint64_t 就是宽度固定的整数类型——uint16_t 恒为 2 字节、uint32_t 恒为 4 字节、uint64_t 恒为 8 字节。这和普通 int 不同:int 在不同平台可能是 2 或 4 字节,而带 _t 的类型在任何平台宽度都一样。这正是材料说“确保跨平台一致性”的意思——文件格式必须精确定死每个字段占几字节,换台机器读才不会错位。
4. 字节序(endianness)
内存里一个多字节数字,字节有“先放高位”还是“先放低位”两种排法:
- 小端(little-endian):低字节在前。比如整数
0x12345678(4 字节)在内存里存成78 56 34 12。x86 就是小端。 - 大端(big-endian):高字节在前,存成
12 34 56 78。
写数字“一千二百三十四”,大端是正常写法从左到右 1234;小端像从个位倒着写 4321。文件头必须声明自己是哪种,否则读文件的人把字节顺序搞反,所有数字全错。
5. 魔数(magic number)
文件最开头几个固定字节,用来“验明身份”。就像身份证照片——机器先看它判断“这是 ELF”。ELF 的魔数是 7F 45 4C 46(即 0x7F + 字母 E L F 的 ASCII 码)。
6. 偏移(offset)
“距离文件开头的第几个字节”。文件被看成一串从 0 开始编号的字节,偏移 64 就是“从第 64 字节开始”。文件头里那些 e_phoff、e_shoff,本质都是“某张表在这串字节的哪个位置”的定位坐标。
7. ABI(Application Binary Interface,应用二进制接口)
程序二进制层面与操作系统、硬件“打交道的一套约定”。可以把它理解成“二进制世界的接口规范”——程序已经编译成机器码后,靠这套约定让系统知道怎么调用它、它遵循什么规矩。
elf.h的类型定义
凭什么保证同一个 ELF 文件在任何机器上读出来都不错位?
答案就两个字:定宽。把“16 位、32 位、64 位”以及“有符号、无符号”全部用固定宽度的类型钉死,并起成有语义的名字。
按用途分四组来看(都是 32 位版 Elf32_* 和 64 位版 Elf64_* 一一对应):
- Half(半字) = 16 位,
uint16_t。用来存“版本号、节区索引”这类小整数。 - Word(字)/ Sword(有符号字) = 32 位。
Word无符号、Sword有符号,存普通计数。 - Xword / Sxword(扩展字) = 64 位,
uint64_t/int64_t。存“大小、长度”这类可能很大的值。 - Addr / Off = 地址、文件偏移。关键点:
Elf32_Addr是uint32_t(32 位地址),Elf64_Addr是uint64_t(64 位地址)——这正是 32 位与 64 位 ELF 最本质的差别。
所以:“64 位和 32 位的关键区别在于地址和偏移大小的差异”。32 位系统内存地址最多 4 字节(能表示约 4GB),64 位系统地址 8 字节(天文数字)。所以凡是“地址”“偏移”字段,32 位版用 4 字节、64 位版用 8 字节,其余结构逻辑完全一致。这也解释了为什么材料选择“以 64 位为准讲”——结构一样,只有字段宽度翻倍。
文件头
字段名里的 e_ 前缀就是 “ELF” 的 e
e_ident[16]——身份标识(16字节)
这是最特殊的一个字段,它不是一个整数,而是16 个字节的数组,头 4 字节就是魔数。
| 字节 | 值 | 含义 |
|---|---|---|
| 0–3 | 7F 45 4C 46 |
魔数:0x7F + E L F |
| 4 | 02 |
文件类别:1=32 位,2=64 位 |
| 5 | 01 |
字节序:1=小端,2=大端 |
| 6 | 01 |
ELF 标识版本,当前为 1 |
| 7 | 00 |
OS ABI:0=System V |
| 8 | 00 |
ABI 版本 |
| 9–15 | 全 00 |
填充字节,保留待用 |
e_type——文件类型(2字节)
就是那张四种类型速查表的落点:
| 宏名 | 值 | 含义 |
|---|---|---|
| ET_REL | 0x0001 | 可重定位文件(.o/.a) |
| ET_EXEC | 0x0002 | 可执行文件 |
| ET_DYN | 0x0003 | 共享目标文件(.so) |
| ET_CORE | 0x0004 | 核心转储文件 |
e_machine —— 目标架构(2 字节):EM_X86_64 = 0x003E(x86-64),EM_ARM = 0x0040(ARM)。
e_version —— 格式版本(4 字节):当前恒为 1(EV_CURRENT)。
e_entry —— 入口点虚拟地址(8 字节):程序开始执行的地址。注意关键区别:目标文件里恒为 0(还没链接、没确定地址);可执行文件里是真实地址(如 0x400430)。
e_phoff —— 程序头表偏移(8 字节):程序头表在文件里的位置。材料说“紧接 ELF 头之后,本例为 64”——因为 ELF 头正好 64 字节。目标文件没有程序头表,恒为 0。
e_shoff —— 节区头表偏移(8 字节):节区头表的位置。.o 里是 1304(0x518),可执行文件里是 6848。
e_flags —— 处理器特定标记(4 字节):与具体 CPU 有关,x86 上通常为 0。
e_ehsize —— ELF 头大小(2 字节):64 位固定 64 字节。
e_phentsize —— 程序头表每项大小(2 字节):64 位固定 56 字节。
e_phnum —— 程序头表项数(2 字节):.o 为 0,可执行文件为 9。
e_shentsize —— 节区头表每项大小(2 字节):64 位固定 64 字节。
e_shnum —— 节区头表项数(2 字节):.o 有 14 项,可执行文件有 31 项。
e_shstrndx —— 节区名字符串表的索引(2 字节):.o 里是 11,指向 .shstrtab 这个节。这个字段等下讲节区头表时会用上,是关键桥梁。
节区头表(Elf64_Shdr)
文件头里的 e_shoff 指向节区头表;这张表是一个数组,每个元素是一个 Elf64_Shdr,描述一个节。
sh_name(4 字节)—— 节区名索引
注意:这里存的是数字,不是字符串。这个数字是“在 .shstrtab(节区名字符串表)里的下标”。所有节的名字集中存在一个字符串表里,这里只记“第几个”。这跟文件头里的 e_shstrndx(指向 .shstrtab)串起来了:e_shstrndx 告诉你去哪找名字库,sh_name 告诉你在名字库里取第几个。
sh_type(4 字节)—— 节区类型,最常用的几个:
SHT_PROGBITS:程序内容(代码.text、数据.data、只读数据.rodata都是它)。SHT_NOBITS:不占文件空间的节——就是.bssSHT_SYMTAB/SHT_DYNSYM:符号表(静态/动态)。SHT_STRTAB:字符串表。SHT_RELA/SHT_REL:重定位表(链接时“对账”用的,RELA带 addend,REL不带)。SHT_DYNAMIC:动态链接信息。
sh_flags(8 字节)—— 节区属性标志,三个最重要的:
SHF_WRITE(W):可写。SHF_ALLOC(A):要加载进内存分配空间。SHF_EXECINSTR(X):包含可执行指令。
这就是上次那张“节权限表”的底层来源——.text 是 AX(可执行+分配),.data 是 WA(可写+分配),.rodata 是 A(只分配,不可写)。
sh_addr(8 字节)—— 节的虚拟地址:加载到内存后的地址。目标文件里全是 0——因为还没链接、地址未分配。
sh_offset(8 字节)—— 节内容在文件里的偏移。注意 .bss 的坑:它是 NOBITS,不占文件空间,所以这个值无实际意义。
sh_size(8 字节)—— 节大小。同样是 .bss:内存大小 > 0,但文件里占 0 字节。
sh_link / sh_info(各 4 字节)—— 链接辅助信息:只在“与链接相关”的节(重定位表、符号表)里有意义,其他节忽略。重定位表要靠它指向“对哪张符号表对账”。
sh_addralign(8 字节)—— 对齐要求:节地址必须是几的倍数。代码节常对齐到 16 字节(性能相关)。
sh_entsize(8 字节)—— 条目大小:只对“表型节”有意义,比如符号表每个条目固定大小,这里记“每个条目几字节”。
节
前置知识
寄存器(register)
CPU 芯片内部自带的“随身小抽屉”——数量极少(十几个)、速度极快的存储格。CPU 做任何计算,数据都得先搬进寄存器。x86-64 常见的:
%rax:万能搬运工,函数返回值也放这;%rdi、%rsi:传参数用——约定第 1 个参数放 rdi、第 2 个放 rsi;%rsp:栈顶指针;%rbp:当前函数栈帧基准。
写法上 %rax 是 64 位、%eax 是它低 32 位那截(同一抽屉的半格)。前面带 % 是 AT&T 汇编语法的习惯。
栈(stack)
栈是程序运行时自动伸缩的一块内存区,专管“函数的临时开销”:局部变量、函数调用返回地址都放这。函数被调用就“压入”一块新空间(栈帧),函数返回就“弹出”销毁。
汇编语言与反汇编(disassembly)
- 汇编语言:机器指令的“人话版”——每条机器指令用一个助记符表示(
mov= 搬运、push= 压栈、call= 调用函数、ret= 返回)。机器码55人看不懂,push %rbp人能看懂。 - 反汇编:把二进制机器码逆向翻译回汇编的过程。干这活的工具就是
objdump -d。
objdump 输出的三列怎么读
1 | |
4e:—— 这条指令在 .text 节内的偏移(第几字节);55—— 机器码(真实存在文件里的字节);push %rbp—— 汇编助记符(翻译给人看的);- 行尾
#注释是 objdump 额外标注的信息。
符号(symbol)
符号就是程序里一个“有名字的东西”的登记条目:一个函数、一个全局变量、一个文件名,都是一个符号。符号表就是这些条目的户口册——记着“叫什么名、住哪个节、多大、给谁看”。
重定位(relocation)
.o 是“零件”,里面地址都是占位符(用 0 先占着位置)。
重定位 = 链接时把占位符替换成真实地址的过程。而重定位表,就是一张“补丁清单”:登记着“文件里哪个位置是个占位符、该用哪个符号的地址去填”。上一节章的 .data 里 const_str 全 0、.text 里 call 后面全 0,全靠它来补。
‘\0’ 与 C 字符串
C 语言里字符串没有“长度前缀”,而是以一个值为 0 的字节 ‘\0’(空字符)作为结束标志。所以存 "ELF Example" 实际要 12 个字节:11 个字符 + 1 个 '\0'。字符串表里“读到 '\0' 为止”就是这个名字的结尾。
nm 与 grep
nm:把文件的符号表整体打印出来的工具(readelf -s 的近亲)。grep:文本搜索工具,从输入里筛出包含指定内容的行;-E表示用扩展正则('00601028|00601030'里的|是“或”——筛出含这两个地址之一的行)。
.text 节区:代码住的地方
节区类型 SHT_PROGBITS,标记 SHF_ALLOC + SHF_EXECINSTR,属性为只读。
和之前的节区表对上:.text 那行 Flg 是 AX——A(要装载进内存)+ X(含可执行指令),没有 W(可写),所以只读。这就是“代码区不许改”在节层面的落实。
1 | |
myPrint 里的模式:
1 | |
三个 0x0 就是重定位的现场:取 const_str、取 g_initVar、调 printf,在 .o 阶段都不知道真实地址,全用 0 占着,等链接器按重定位表补。这就是上节“重定位”概念在代码里的样子。
开头结尾的固定套路:
1 | |
main 里的一条关键指令:
1 | |
tmp_var 不在文件的数据节里,文件里只有‘创建它的指令’,变量运行时才诞生在栈上——movl $0xa,-0x4(%rbp) 这条指令就是那个“创建指令”本尊:0xa 就是十进制 10,目标是栈上 rbp-4 的位置。
.data节区:逐字节看小端序
存储已初始化的全局变量和静态变量,类型 SHT_PROGBITS,标志 SHF_ALLOC + SHF_WRITE(WA,可读写)。
通过readelf工具查看目标为文件elfExample.o的.data节区的内容:
$ readelf -x .data elfExample.o

Hex dump of section '.data':
 NOTE: This section has relocations against it, but these have NOT been applied to this dump.
  0x00000000 00000000 00000000 00040000 08000000 ................
readelf -x 输出的格式:第一列 0x00000000 是节内偏移,中间是原始字节的十六进制,右边是 objdump 猜测的 ASCII 对照。开头那行 NOTE: This section has relocations against it... 意思是:“这个节里有重定位占位符,本输出显示的是原始文件内容,重定位还没做”——提醒看到的 0 不是真 0。
逐字节解码(小端序:数值的低字节放在内存最前面)。把这 16 个字节按变量分组还原: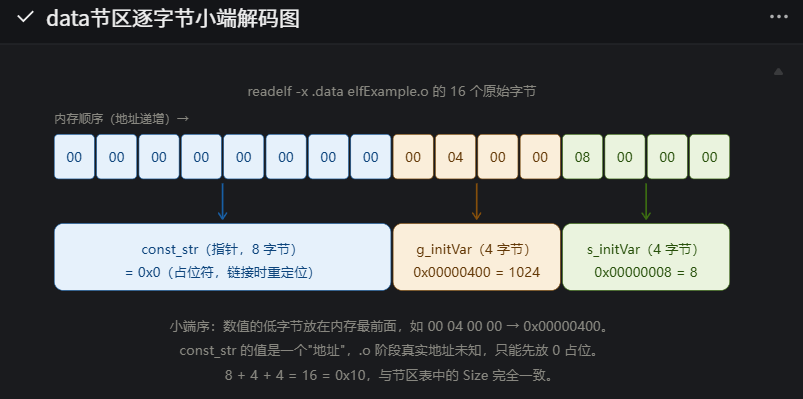
可执行文件的 .data——重定位“前 vs 后”的:
1 | |
同一个变量,链接前是 0、链接后是真实地址 0x400624——这就是重定位表干的话。
另外链接后的 .data 开头多了 16 字节(__data_start 和 __dso_handle,均 0):这不是源码里的变量,而是链接器自动塞进来的“标记符号”——前者标记数据段起点(给系统运行时用),后者是共享对象句柄(C++ 全局构造/析构机制要用)。可执行文件的 .data 比目标文件“胖”,就胖在这。
.rodata节区:手工解码字符串
存放只读数据:const 修饰的变量和字符串常量,属性 A(只装载,不可写)。
1 | |
45 4c 46 20 45 78 61 6d 70 6c 65 00 → E L F (空格) E x a m p l e '\0' —— 正是 "ELF Example" + 结尾的 '\0',共 12 字节。
紧接着 63 6f 6e 73 ... 开拼 "const_str: %s\n" + '\0'。可以看到所有字符串背靠背紧密排布,中间只用一个 '\0' 隔开——节区内不留一点缝隙,这是编译器省空间的典型手法。三段格式串全在这,0x39 = 57 字节的总大小正好装下它们。
.bss节区
存放未初始化的或初始化为 0 的全局变量和静态变量。初始化为 0 的也放 .bss——因为 0 值不用存进文件,加载时统一清零即可,省文件空间。
1 | |
.bss 大小 0x4 = 4 字节,但 g_uninitVar + s_uninitVar 应该是 8 字节,这是为什么?——COMMON 符号。
COMMON 是怎么回事? 用 objdump -x 的符号表(材料已给出)看:
1 | |
s_uninitVar是 static(局部符号),编译器直接安排进.bss,占 4 字节——这就是.bsssize=4 的来源。g_uninitVar是未初始化的全局符号,这个老式编译器没有立刻给它安排位置,只在符号表里登记了一个“预订”:类型*COM*(COMMON),大小 4 字节,注释“先记账,等最终链接成可执行文件时再统一分配空间”。
GCC 10(2020 年)起默认改为 -fno-common——未初始化全局变量直接放进 .bss,不再产生 COMMON 符号。所以在现代 GCC 上编译同样的代码,.bss 大小会是 8 字节,符号表里 g_uninitVar 的 Ndx 是 .bss 而不是 COM。
重定位表:补丁清单本身
.rela.text、.rela.data、.rela.eh_frame 的类型都是 SHT_RELA。链接器需要对目标文件某些部位进行重定位,如对 printf 的调用。
表本身怎么读:
- 重定位表也是一个节区,每个表项 = 一条补丁记录:“某节区内偏移 X 处是个占位符,用某符号(加上附加常数 addend)计算出的值来填”。
- Lk(sh_link)= 符号表的下标:告诉链接器“查哪本户口册”(本文件都是 12,即
.symtab)。 - Inf(sh_info)= 作用于哪个节区:
.rela.text的 Inf=1 → 修.text(节区下标 1);.rela.data的 Inf=3 → 修.data。回看上节节区表:.text正是[1]、.data正是[3],闭环。 - addend(附加数):补丁值 = 符号地址 + addend 的一个附加常数。x86-64 的很多指令寻址方式要在“符号地址”基础上再加减一个偏移量,addend 就是把这个修正量直接写在补丁条目里。
字符串表:名字是怎么存的
字符串长度不固定,常见做法是把字符串集中存到一个表里,用偏移来引用,’\0’ 作为结束符。
为什么要这么绕? 如果每个节区头直接内嵌名字字符串,头结构体的大小就没法固定(名字长短不一),定宽设计就崩了。集中存放后,每个头里只存一个定宽的 4 字节偏移数字,名字本体放在“字符串仓库”里。
ELF 里有两张字符串表,分工不同:
- .shstrtab:存节区名字(”.text”、”.data” 这些);
- .strtab:存符号名字(”myPrint”、”g_initVar” 这些)。
两者类型都是 SHT_STRTAB,别混淆——谁用哪张,靠引用它的结构里的字段指定(节区头用 e_shstrndx 找 .shstrtab;符号表用 sh_link 找 .strtab,本文件里 .symtab 的 Lk=13 正指向 .strtab)。
取名流程
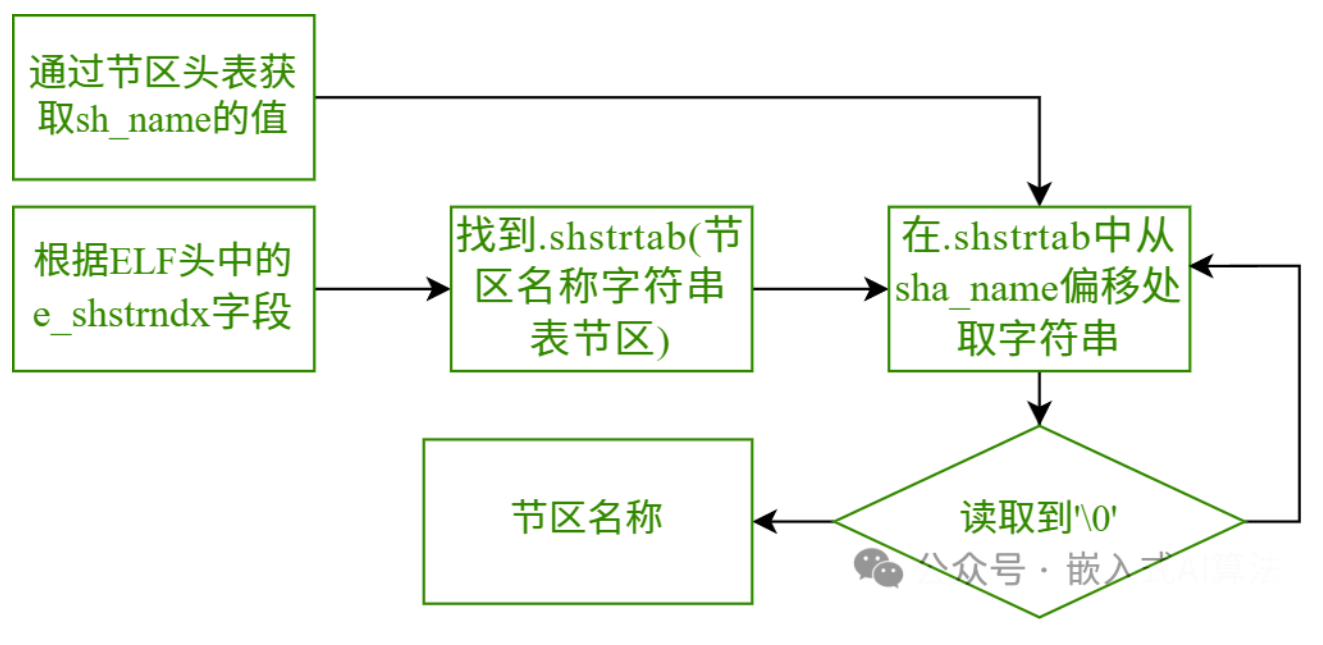
节区头表取 sh_name → ELF 头的 e_shstrndx 找到 .shstrtab → 偏移定位 → 逐字节读到 '\0' → 得到名字。符号名的读取一模一样,只是仓库换成 .strtab、偏移来自符号表项的 st_name 字段
符号表:整个文件的“户口册”
作用:1)链接阶段把不同 .o 的符号引用和符号定义匹配起来;
2)调试器靠它把源码里的变量/函数映射到可执行文件的地址。
.symtab 与 .dynsym 的分工:前者是静态链接时用的全量户口册;后者是运行时动态链接用的精简册(只登记需要跨文件动态解析的符号),只存在于可执行文件和 .so 里。
readelf -s 输出逐列讲
1 | |
1 | |
- Num:条目编号。第 0 条永远是空占位(和节区表第 0 项同理)。
- Value:符号值。在
.o里是**“所在节内的偏移”;链接成可执行文件后才变成虚拟地址**。注意myPrintValue=0(.text 内偏移 0)、mainValue=0x4e——正好接在 myPrint 后面,又对上了。 - Size:符号大小(字节)。
myPrint78、main32、const_str8(64 位指针)、各 int 变量 4——全是实打实的账目。 - Type:符号类型——
FUNC函数、OBJECT数据对象(变量/数组)、FILE文件名、SECTION节区、NOTYPE无类型。 - Bind:绑定(可见性)——下面细讲。
- Vis:可见性,
DEFAULT是常态,暂不用管。 - Ndx:符号住在哪个节——数字 = 节区表下标;三个特殊值:
UND未定义(定义在别处)、COMCOMMON、ABS绝对值(不随重定位变化,如 FILE 符号)。 -
为什么有一堆 SECTION 符号?(那些 Name 为空的条目)它们是编译器生成的“节区代表”,作用是让重定位条目能引用“某个节”本身(比如“填入 .rodata 的基地址 + 偏移”)。平时看着没用,链接时是重要中介。
Bind 三种绑定
- LOCAL(局部):文件外部看不见。
static变量全是 LOCAL - GLOBAL(全局):对外可见,链接时可跨文件匹配。
- WEAK(弱符号):可以被覆盖的“默认实现”。规则:链接时若同名符号既有 GLOBAL 又有 WEAK,GLOBAL 赢;只有多个 WEAK,随便挑一个不报错。用途:库给一个默认空实现,用户可自定义覆盖。
nm输出里data_start旁的W就是弱符号标记。
Elf64_Sym 结构体逐字段
- st_name(4 字节):符号名在 .strtab 里的字节偏移——注意是符号名仓库,不是
.shstrtab,两者分工不同。 - st_info(1 字节):打包了两个信息——低 4 位 = 类型(STT_FUNC/OBJECT/…),高 4 位 = 绑定(STB_LOCAL/GLOBAL/WEAK)。
- st_other(1 字节):它的低 2 位实际定义了符号可见性(DEFAULT/HIDDEN/PROTECTED,控制符号是否导出到动态符号表),只是绝大多数符号取 DEFAULT(0),所以常见输出里它确实是 0——“常见为 0”和“未使用”是两回事。
- st_shndx(2 字节):符号所在节区的下标,即 Ndx 列的来源;特殊值 UND/COM/ABS 也由它表达。
- st_value(8 字节):符号值(
.o里是节内偏移,链接后是虚拟地址)。 - st_size(8 字节):符号大小。
程序头表
前置
1. 物理地址与虚拟地址——为什么有两个地址列
输出里 VirtAddr 和 PhysAddr 并排出现,必须先分清:
- 物理地址(Physical Address):内存条(RAM 硬件)上真实的、一个萝卜一个坑的存储单元编号。
- 虚拟地址(Virtual Address):程序眼里的地址。操作系统给每个程序一个假象:“你独占一整条内存条,从 0 开始编号”。程序里写的、文件头里记的地址全是虚拟地址。CPU 执行时由硬件(MMU,内存管理单元)拿着一张“对照表”(页表)把虚拟地址翻译成物理地址。
为什么要多此一举? 三个理由:① 每个程序都从固定地址开始编译,互不干扰——两个程序都用 0x400000 也没冲突,因为翻译后落在不同物理位置;② 安全:程序摸不到真实硬件布局,也看不见别的进程;③ 便于系统统一调度内存。
2. 内存页(page)——权限的“最小贴标签单位”
操作系统管理内存不是按字节管的,是按页管的:把内存切成固定大小的块(x86-64 常规页 4KB = 4096 字节),权限(R/W/X)只能整页整页地贴标签——一页之内不能“前半页可写、后半页只读”。
这就直接解释了两个现象:① 段的权限能被硬件强制,靠的就是“一个段整对齐到页,独占若干页,然后整页贴标签”;② 输出里 LOAD 段的 Align 是 200000——十六进制 0x200000 = 2MB,段与段之间按 2MB 大边界对齐,保证不同权限的段绝不会挤进同一个页里“串味”。
3. 动态链接器与 PT_INTERP
动态链接的程序运行时由“动态连接器”负责把 .so 加载进来。当时没说的是——程序自己会在文件里写明“我的连接器是谁”。这个信息就放在 INTERP 段里:一个路径字符串 /lib64/ld-linux-x86-64.so.2。内核加载程序时读到它,就先把这个连接器程序装进内存,把控制权先交给它,由它再去搬 libc 等库。所以 ld-linux 又叫“程序解释器(interpreter)”——它本身也是个 ELF 可执行文件。
4. PT_GNU_* 前缀:GNU 的私有扩展
ELF 标准只规定了 PHDR/LOAD/DYNAMIC/INTERP/NOTE 这几种基础段类型;PT_GNU_STACK、PT_GNU_RELRO、PT_GNU_EH_FRAME 是 GNU 工具链自己加的扩展(Standard 里没有,各家工具链可以定义自己的,用 vendor 名做前缀)。
使用readelf工具查看程序头表:
1 | |
详讲
表项结构:
Type —— 段类型(这表项是干嘛的)
| 类型 | 作用 | 大白话 |
|---|---|---|
| PT_PHDR | 描述程序头表自己 | 装箱单的第一条是“本清单放在哪” |
| PT_LOAD | 要装载进内存的段 | “这一整箱要搬进新家”,唯一真正占内存的类型 |
| PT_DYNAMIC | 动态链接信息 | 动态连接器的“工作指引”,指向 .dynamic 节 |
| PT_INTERP | 指定动态链接器路径 | “开工前先去接这个人”(ld-linux) |
| PT_NOTE | 辅助信息 | 附注:构建 ID、ABI 标记等(纠错:材料写成 PT_NODE,应为 PT_NOTE) |
| PT_GNU_EH_FRAME | 异常栈回溯表位置 | 程序崩溃时还原“调用链”用的索引 |
| PT_GNU_STACK | 声明栈的权限 | 重点看它有没有 X(后面安全拓展细讲) |
| PT_GNU_RELRO | 重定位后改只读的区域 | 动态链接收尾后“封条贴上、不许再改”的内存范围 |
Offset / VirtAddr / PhysAddr:段从文件的第几字节来(Offset)、装到内存虚拟地址哪(VirtAddr)、物理地址哪(PhysAddr,现代通用系统上内核自己安排,通常与 VirtAddr 相同地写着,程序运行根本用不到它——所以这两列永远一样,不用纠结)。
FileSiz / MemSiz:这一段在文件里占多少字节、在内存里占多少字节。两者为什么可能不等?因为 .bss——文件里没实体、内存里要清零的那截。这就是之前“NOBITS 只记账”在段层面的镜像:MemSiz ≥ FileSiz,多出来的部分由加载器负责清零。
Flags —— 段权限:R(PF_R 可读)、W(PF_W 可写)、X(PF_X 可执行)的组合。PF_MASKPROC 是留给处理器厂商的私有标记位,x86 上见不到
Align:对齐要求——段的起始地址和长度必须满足的对齐约束,LOAD 段是 0x200000(2MB,配合页粒度),NOTE 是 4 字节。
九个段
1 | |
① PHDR(offset 0x40,大小 0x1f8):0x1f8 = 504 字节 = 9 项 × 每项 56 字节,而上节 ELF 头里 e_phnum=9、e_phentsize=56。
② INTERP(大小 0x1c = 28 字节):/lib64/ld-linux-x86-64.so.2 数一数正好 27 个字符,加结尾 '\0' 一个字节 = 28。
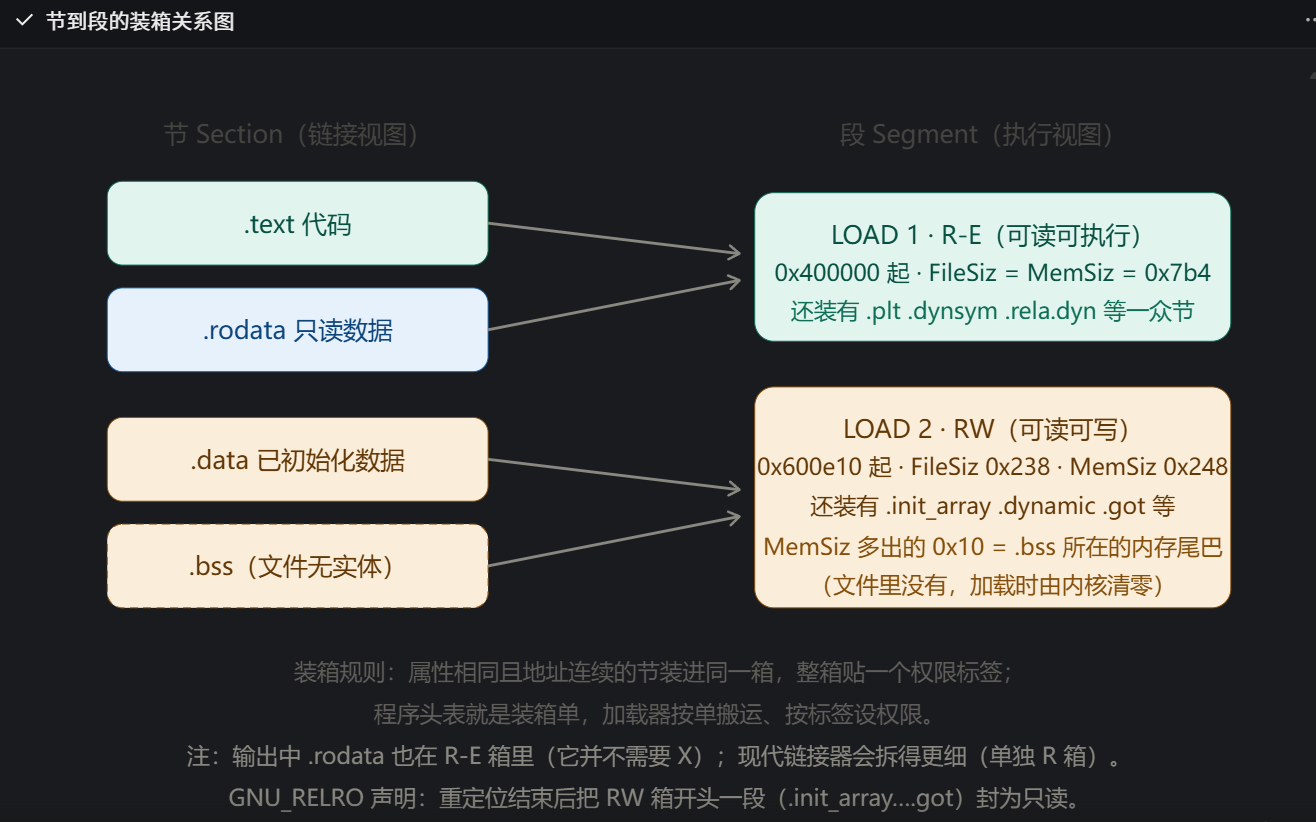
③ LOAD R-E(0x400000 起,FileSiz = MemSiz = 0x7b4):第一箱,可读可执行。注意它的 offset 是 0——从文件第 0 字节开始整箱搬,意味着 ELF 头、程序头表本身也会被映射进内存。FileSiz = MemSiz 说明这箱全是“有实体”的内容,不需要内存补零。
④ LOAD RW(0x600e10 起,FileSiz 0x238,MemSiz 0x248):第二箱,可读可写。MemSiz 比 FileSiz 大 0x10 = 16 字节——这就是 .bss:我们那两个未初始化变量(g_uninitVar、s_uninitVar)连同对齐填充,只存在于内存、文件里没有。上一节 COMMON 符号了结了“为什么只有 4 字节”,不管 .bss 在目标文件里怎么记账,最终链接后它一律体现为 MemSiz > FileSiz。
⑤ DYNAMIC(0x600e28):指向 .dynamic 节——动态连接器的工作清单(依赖哪些库、要重定位哪些符号),等材料讲到动态链接时展开。
⑥ NOTE:附注信息,主要是 build-id(构建唯一指纹,调试符号服务器靠它匹配符号)和 ABI 版本标记。
⑦ GNU_EH_FRAME:指向 .eh_frame_hdr。EH = Exception Handling,崩溃或抛异常时按它“逐层倒查函数调用链”。调试器 backtrace、崩溃日志里的调用栈,底层靠它。
⑧ GNU_STACK(全 0,权限 RW):这是个空段——不占文件不占内存,纯粹是一张“声明”:我的栈要 RW 权限。注意 Flags 里没有 E。这张声明不是摆设,含义重大,放拓展里讲(NX)。
⑨ GNU_RELRO(R 权限,范围 0x600e10 起 0x1f0 字节):声明“动态链接做完重定位后,把这一片改成只读”。对照映射表第 08 行:它覆盖 .init_array .fini_array .jcr .dynamic .got——注意里面没有 .got.plt。
顺带一个拓展:入口点 0x400430 并不是 main 的地址。它是 glibc 启动代码 _start 的地址——真正流程是内核把控制权交给 _start,_start 设置好环境后调 __libc_start_main,由它去调用你的 main。所以“程序入口”和“写的第一个函数”之间隔着一层运行时启动代码。
节 → 段映射
具有相同属性的 Section 会被链接器归类到一个 Segment 中。
- 00:空。PHDR 段对应“程序头表自己”,不算节。
- 01:
.interp——独占,连接器路径字符串。 - 02(LOAD R-E 大箱):
.interp(搬进来一起映射省事)、.note.ABI-tag/.note.gnu.build-id(附注)、.gnu.hash/.dynsym/.dynstr/.gnu.version/.gnu.version_r(动态符号体系:运行时符号的哈希索引、动态符号表、动态字符串表、版本信息)、.rela.dyn/.rela.plt(运行时重定位表:上一节 SHT_RELA 的动态版兄弟,分别管数据重定位和 PLT 函数重定位)、.init/.fini(进程启动/退出时执行的初始化/收尾代码)、.plt/.plt.got(过程链接表,调用动态库函数的中转站)、.text(我们的代码)、.fini、.rodata、.eh_frame_hdr/.eh_frame。 - 03(LOAD RW 大箱):
.init_array/.fini_array(启动/退出时要逐个调用的函数指针数组,全局对象构造析构靠它)、.jcr(Java/C++ 兼容注册,现代基本是空壳)、.dynamic(动态链接信息本体)、.got/.got.plt(全局偏移表,存“外部数据/函数的真实地址”的跳板表)、.data、.bss。 - 04:
.dynamic——DYNAMIC 段精确指向这一个节。 - 05:两个 note 节。
- 06:
.eh_frame_hdr。 - 07:空——GNU_STACK 是纯声明。
- 08:RELRO 封条范围:
.init_array .fini_array .jcr .dynamic .got——没有 .got.plt。